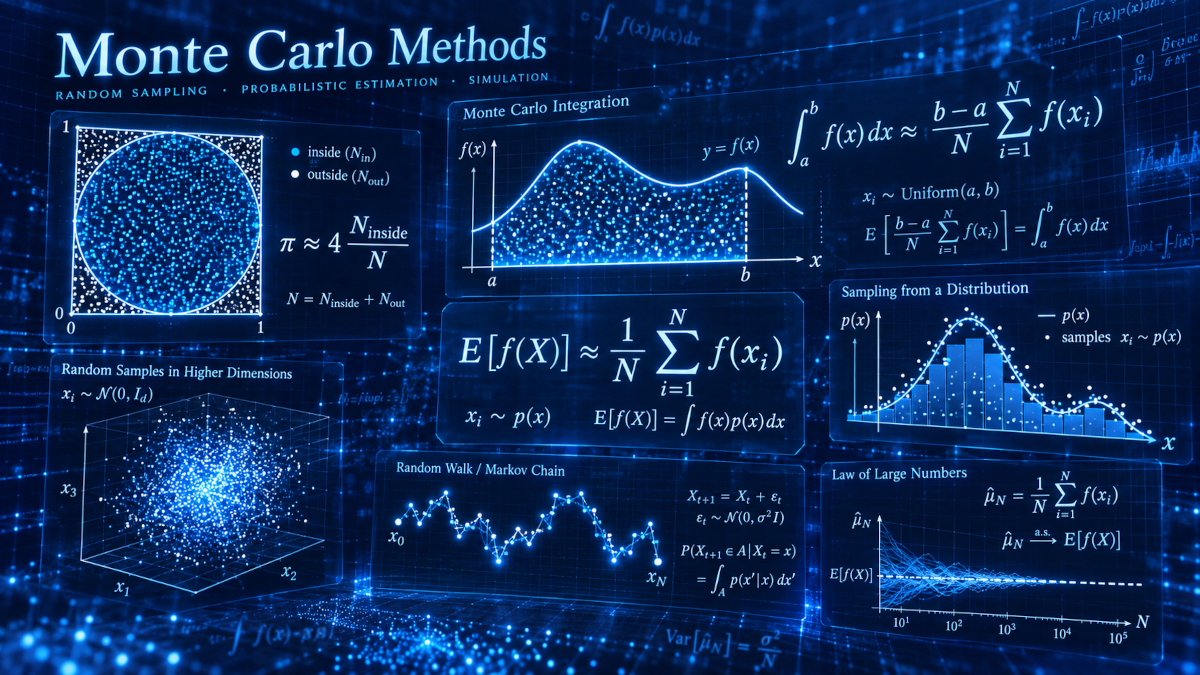
Bir olasılığı, ortalamayı veya integrali doğrudan hesaplamak güçse rastgele seçilmiş örneklerden yaklaşık bir değer bulabiliriz. Monte Carlo yöntemleri bu fikre dayanır. Aynı yaklaşım, bir yapay zekâ modelinin farklı durumlardaki ortalama hatasını tahmin etmemize de yardım eder. Zar ve alan örnekleriyle başlayıp örnek ortalamasının neden işe yaradığını, hatasını nasıl ölçtüğümüzü, hangi varsayımlarda yanıltıcı olabileceğini ve model eğitiminde neyi yaklaşık hesapladığımızı inceleyeceğiz.
 Matematik
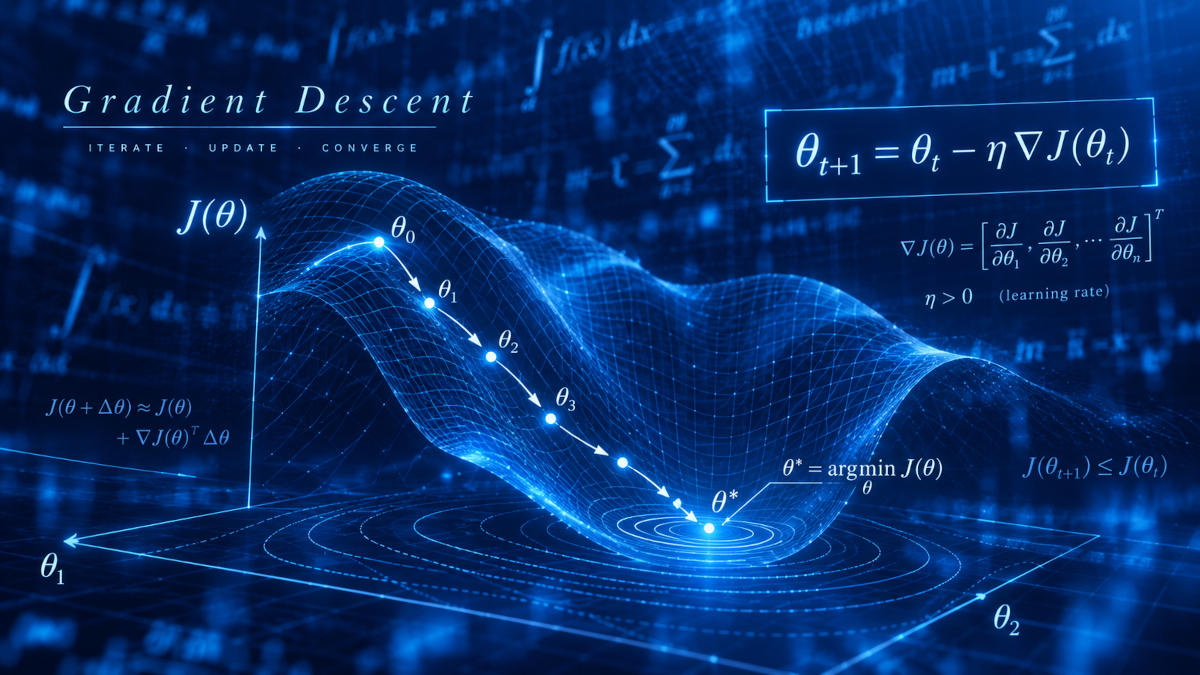
27. Gradyan İnişi (Gradient Descent) ve Öğrenme Oranı (Learning Rate)
20 dakika
7 görüntüleme
Bir modelin hatasını ölçmek kolay olabilir; en düşük hatayı veren ayarları bulmak her zaman kolay değildir. Gradyan inişinde bulunduğumuz noktadaki eğime bakar, maliyetin azaldığı yöne doğru tekrar tekrar adım atarız. Öğrenme oranı bu adımların ölçeğini belirler. Önce tek bir teslimat süresi tahmininde güncellemeleri hesaplayacak, ardından farklı öğrenme oranlarını ve iki parametreli bir modeli inceleyeceğiz.
29 Eylül 2026
 Matematik
26. Optimizasyon Nedir? Maliyet Fonksiyonları
5 dakika
6 görüntüleme
Bir modelin hatasını ölçtükten sonra hangi ayarların bu hatayı azaltacağını bulmamız gerekir. İzin verilen seçenekler arasından amacımıza en uygun olanı aramaya optimizasyon, amacı sayıyla ifade eden kurala maliyet fonksiyonu deriz. Bir teslimat süresi tahmininden başlayıp kareli ve mutlak hatanın neden farklı seçimlere götürdüğünü hesaplayacağız. Ardından çapraz entropiyi bu çerçevede kullanacak ve düşük eğitim maliyetinin sınırlarını inceleyeceğiz.
28 Eylül 2026
 Matematik
25. Çapraz Entropi (Cross-Entropy) ve KL Iraksaması (KL Divergence)
19 dakika
15 görüntüleme
Gerçekleşen sonuçlara modelin ne kadar olasılık verdiğini bilirsek tahminin bedelini ölçebiliriz. Çapraz entropi bu olasılıkları gerçek sonuçların sıklığına göre ortalar. KL ıraksaması, ortaya çıkan bedelin gerçek dağılımı bilseydik kaçınabileceğimiz kısmını gösterir. İki renkli bir kutuyla başlayıp bu ölçüleri hesaplayacak, sıfır olasılık durumunu ve yapay zekâ eğitimindeki karşılıklarını inceleyeceğiz.
27 Eylül 2026
 Matematik
24. Entropi
21 dakika
16 görüntüleme
Bir olayın olasılığını biliyorsak gerçekleştiğinde ne kadar şaşıracağımızı da ölçebiliriz. Entropi, bu şaşkınlığı bütün olası sonuçlar için ortalayıp henüz sonucu görmeden ne kadar belirsizlik taşıdığımızı söyler. Aynı hesap, verinin sıkıştırılmasında ve bir karar ağacının soracağı soruyu seçmesinde karşımıza çıkar. Olasılık ve logaritmadan başlayarak bilgi miktarına ulaşacak; entropiyi farklı dağılımlarda hesaplayıp sınırlarını ve yapay zekâdaki kullanımını göreceğiz.
26 Eylül 2026
 Matematik
23. Yaygın İstatistiksel Testler: T-Testi ve ANOVA
26 dakika
57 görüntüleme
İki ortalama farklı çıktığında, gördüğümüz fark rastgele dalgalanmayla açıklanabilir mi? T-testi ve ANOVA, örneklem ortalamalarını bu soruyla incelememizi sağlar. Bir üretim sürecinin hedef değerden sapmasını, iki yöntemin ortalama sonucunu veya üç ya da daha fazla grubun performansını karşılaştırırken doğru testi seçmemiz gerekir. Bu dikkat, yapay zekâ deneylerinde görülen küçük kazanımları gerçek ve genellenebilir bir iyileşme sanmamızı da önler. Bu makalede önce Student’ın t dağılımını sezgisel olarak kurup tek örneklem, bağımsız gruplar ve eşleştirilmiş t-testlerini adım adım hesaplayacağız. Ardından ANOVA’nın toplam değişkenliği gruplar arası ve grup içi parçalara nasıl ayırdığını görecek; sonuçları değerlendirirken varsayımları ve etki büyüklüklerini nasıl dikkate alacağımızı inceleyeceğiz.
19 Eylül 2026
 Matematik
22. Çıkarımsal İstatistik ve Hipotezler
28 dakika
57 görüntüleme
Sınırlı sayıdaki gözlemden daha büyük bir anakütle hakkında ne söyleyebiliriz? Çıkarımsal istatistik, örneklemenin getirdiği belirsizliği hesaba katarak ölçülü sonuçlar çıkarmamızı sağlar. Yapay zekâda da bir modelin test verisindeki başarısının, henüz karşılaşmadığı verilerde sürüp sürmeyeceğini değerlendirirken bu düşünceye ihtiyaç duyarız. Bu makalede örnekleme belirsizliğinin nasıl ortaya çıktığını günlük örnekler ve hesaplamalarla adım adım inceleyeceğiz. Önce örnekleme dağılımı, standart hata ve merkezî limit teoremini ele alıp nokta ve aralık tahminine, ardından güven aralığına geçeceğiz. Sonra sıfır ve alternatif hipotezleri, p-değerini, anlamlılık düzeyini, hata türlerini, test gücünü ve etki büyüklüğünü inceleyeceğiz.
18 Eylül 2026
 Matematik
21. Korelasyon ve Regresyon Analizi
27 dakika
47 görüntüleme
İki sayısal değişken birlikte değiştiğinde, aralarındaki ilişkinin yönünü ve gücünü korelasyonla inceleriz. Regresyon ise bu ilişkiyi bir denklemle özetleyip bir değişkenin değerinden diğerine yönelik tahmin üretmemizi sağlar. Bu iki araç, verideki örüntüleri görmemize ve yapay zekâ modellerinin temel çalışma mantığını anlamamıza yardımcı olur. Bu makalede önce saçılım grafiğiyle ilişkiyi gözlemleyecek, ardından kovaryans ve korelasyonu inceleyeceğiz. Doğrusal regresyon doğrusunu en küçük kareler düşüncesinden adım adım türettikten sonra artıkları, hata ölçülerini ve açıklanan değişkenliği ele alacağız. Aykırı değerleri, doğrusal olmayan ilişkileri ve “korelasyon nedensellik değildir” uyarısını da sonuçları yorumlarken birlikte değerlendireceğiz.
17 Eylül 2026
 Matematik
20. Betimsel İstatistik: Merkez ve Dağılım
26 dakika
58 görüntüleme
Ham veriye baktığımızda değerlerin nerede toplandığını, ne kadar yayıldığını ve dağılımın nasıl bir biçim aldığını hemen göremeyebiliriz. Betimsel istatistik, gözlemleri birkaç anlamlı ölçüyle özetleyerek bunları görmemizi sağlar. Yapay zekâ modeli kurmadan önce veriyi tanımak ve olağandışı değerleri fark etmek için bu özetlere başvururuz; model sonuçlarını yorumlarken de onlardan yararlanırız. Bu makalede tek bir veri kümesi üzerinde önce ortalama, ortanca ve tepe değeri, ardından açıklık, çeyrekler arası açıklık, varyans ve standart sapmayı adım adım hesaplayacağız. Her ölçünün bize ne söylediğini ve hangi durumda yanıltıcı olabileceğini de inceleyeceğiz.
16 Eylül 2026
 Matematik
19. Olabilirlik, Log-Olabilirlik ve Parametre Tahmini: MLE ile MAP
23 dakika
73 görüntüleme
Gözlediğimiz veriye hangi model ayarı daha iyi uyuyor? Olabilirlik, farklı ayarları bu soruyla karşılaştırmamızı sağlar. En yüksek olabilirlik tahmini (MLE), yalnızca veriye bakarak en uyumlu parametreyi seçer. En yüksek sonsal tahmin (MAP) ise önceki bilgiyi de hesaba katar. Bu makalede önce bir madeni para örneğiyle temel fikri kuracağız. Ardından log-olabilirliği neden kullandığımızı, MLE ile MAP arasındaki farkı ve olabilirlik yaklaşımının yapay zekâdaki kayıp fonksiyonlarına nasıl dönüştüğünü adım adım inceleyeceğiz.
15 Eylül 2026
 Matematik
18. Beklenen Değer ve Varyans
19 dakika
69 görüntüleme
Bir kafe yarın kaç müşteri beklemeli? Aynı belirsiz durumu defalarca yaşasaydık sonuçların uzun dönem ortalamasının yaklaşacağı değeri beklenen değer anlatır. Varyans ise tek tek sonuçların bu ortalama çevresinde ne kadar yayıldığını gösterir. Bir yapay zekâ modelinin ortalama hatasını ve tahminlerindeki belirsizliği anlamak için de bu iki ölçüyü birlikte kullanırız. Bu makalede merkez ve yayılım fikrini günlük örneklerle kuracak, ardından formüllerin ne söylediğini adım adım inceleyeceğiz.
14 Eylül 2026