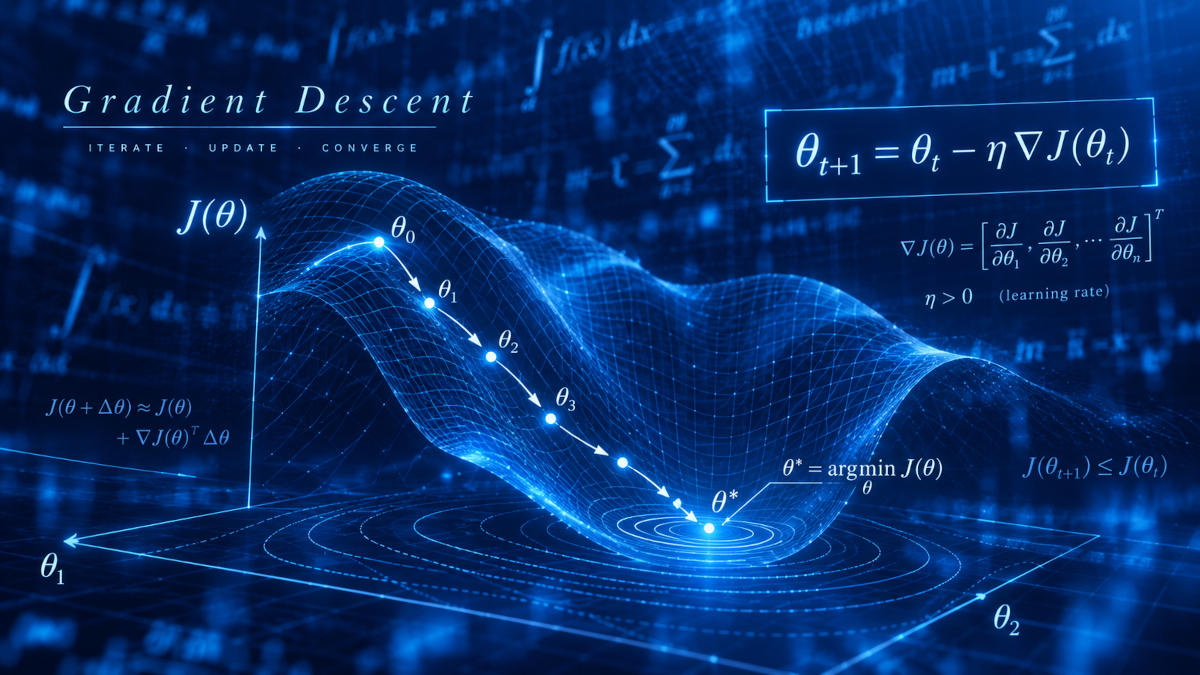
Bir modelin hatasını ölçmek kolay olabilir; en düşük hatayı veren ayarları bulmak her zaman kolay değildir. Gradyan inişinde bulunduğumuz noktadaki eğime bakar, maliyetin azaldığı yöne doğru tekrar tekrar adım atarız. Öğrenme oranı bu adımların ölçeğini belirler. Önce tek bir teslimat süresi tahmininde güncellemeleri hesaplayacak, ardından farklı öğrenme oranlarını ve iki parametreli bir modeli inceleyeceğiz.
En İyi Değeri Biliyorsak Neden Adım Atalım?
Optimizasyon Nedir? Maliyet Fonksiyonları yazısındaki üç teslimat 2, 4 ve 12 saat sürmüştü. Hepsi için aynı \(c\) saatlik tahmini yapıyor, kareli hataların ortalamasını küçültüyorduk. Kare tamamlama bize şu ifadeyi vermişti:
\(c\) saat cinsinden ortak tahmin, \(J(c)\) ise saat kare cinsinden ortalama kare hatadır. Formülden en iyi tahminin \(c=6\) olduğunu hemen görüyoruz. Parametre sayısı arttığında kare tamamlama çoğu zaman işe yaramaz; bütün seçenekleri tek tek denemek de güçleşir.
\(6\)'yı bilmeden \(c=0\) tahminiyle başladığımızı düşünelim. Tahminimiz zayıf, ama bu noktadaki maliyeti ve eğimi hesaplayabiliyoruz. Bunlarla daha iyi bir değere doğru ilerleyebiliriz.
Eğim Bize Hangi Yönü Söylüyor?
Bir yokuş sağa doğru yükseliyorsa aşağı inmek için sola yürürüz. Türev yazısındaki eğim, maliyetin bulunduğumuz noktadan sağa giderken artıp artmadığını söyler. Teslimat maliyetinin türevi:
\((c-6)^2\)'nin türevini zincir kuralıyla aldık; sabit \(56/3\)'ün türevi sıfır. \(c=0\) noktasında \(J'(0)=-12\): \(c\)'yi biraz artırırsak maliyet düşer. \(c=10\) için \(J'(10)=8\); orada ise \(c\)'yi azaltmak gerekir.
Eğim yalnızca küçük bir değişimin ilk etkisini anlatır. \(c\)'yi \(\Delta c\) kadar değiştirdiğimizde yerel yaklaşım şöyledir:
Türev negatifken \(\Delta c\)'yi pozitif seçersek çarpım negatif olur ve yaklaşık maliyet düşer. Türev pozitifken ters yönde ilerlemeliyiz. İki durumu da türevin ters yönünde adım atarak karşılarız: Pozitif \(\eta\) için \(\Delta c=-\eta J'(c)\) seçersek yerel yaklaşımda maliyet değişimi \(-\eta[J'(c)]^2\) olur. Türev sıfır değilse bu ilk etki negatiftir.
Bu sonuç küçük adımlar için yerel bir yaklaşıma dayanır. Uzağa gittiğimizde eğrinin kıvrımı önem kazanır ve maliyet artabilir. Bu yüzden adımın büyüklüğünü seçmemiz gerekir.
Gradyan İnişi Kuralını Kuralım
Başlangıç tahminini \(c_0\), sonraki iki tahmini \(c_1\) ve \(c_2\) ile gösterelim. Alt indis \(t\), adım numarasıdır. Her adımda eğimi o anki tahminde yeniden hesaplarız:
Tek parametrede bu güncellemeye gradyan inişi (gradient descent) deriz. \(J'(c_t)\) yerel eğimi, öğrenme oranı (learning rate) \(\eta\) adımın ölçeğini belirler. \(\eta\) sabit bir saat miktarı değildir: Parametre değişimi \(-\eta J'(c_t)\)'dir, dolayısıyla eğimle birlikte değişir.
Türev negatifse \(-\eta J'\) pozitif olur ve parametre artar; pozitifse adım negatif olur ve parametre azalır. Türev sıfırken parametre yerinde kalır. Bu duraklama, en iyi noktaya ulaştığımızı tek başına göstermez.
Sıfırdan Başlayıp Üç Adım Atalım
\(c_0=0\) ve \(\eta=0{,}25\) ile başlayalım:
Başlangıçta maliyet \(J(0)=36+56/3=164/3\approx54{,}67\) saat kareydi. Bir adımda \(c\) sıfırdan 3 saate çıktı, maliyet 54,67'den yaklaşık 27,67 saat kareye indi. Sonraki adımda eski \(-12\) eğimini kullanamayız; eğimi \(c=3\)'te yeniden hesaplarız:
Üçüncü adımın eğimi \(J'(4{,}5)=-3\), yeni tahmin \(c_3=4{,}5-0{,}25(-3)=5{,}25\), maliyet ise yaklaşık \(19{,}23\) saat karedir. Üç adımın tamamı tabloda görülebilir:
| Adım \(t\) | Tahmin \(c_t\) (saat) | Eğim \(J'(c_t)\) | Maliyet \(J(c_t)\) (saat²) |
|---|---|---|---|
| 0 | 0 | -12 | 54,67 |
| 1 | 3 | -6 | 27,67 |
| 2 | 4,5 | -3 | 20,92 |
| 3 | 5,25 | -1,5 | 19,23 |
6 saate yaklaşırken eğimin büyüklüğü küçüldü. \(\eta\) değişmediği hâlde adımlar 3, 1,5 ve 0,75 saate kısaldı. En küçük maliyet \(56/3\approx18{,}67\) saat kare; üç adımın sonunda ona henüz ulaşmadık.
Öğrenme Oranı Küçükse Ne Olur?
Başlangıç yine \(c_0=0\) olsun, ama \(\eta=0{,}01\) seçelim. İlk adım \(c_1=0-0{,}01(-12)=0{,}12\) olur. Doğru yöne gittik; 6 saate yaklaşmamız ise çok sayıda güncelleme ister. Çok küçük öğrenme oranıyla ayrılan adım sayısı bitmeden iyi bir noktaya varamayabiliriz.
Bir öğrenme oranına kendi başına “küçük” diyemeyiz. Aynı \(\eta\), başka bir maliyet fonksiyonunda ya da aynı fonksiyon farklı ölçekle yazıldığında bambaşka adımlar üretebilir. Sayısal oranın yanında gerçek parametre değişimini ve maliyetin seyrini de izlemeliyiz.
Çukuru Geçmek Her Zaman Kötü mü?
Öğrenme oranını \(0{,}75\)'e çıkaralım. İlk eğim yine \(-12\), ama şimdi \(c_1=0-0{,}75(-12)=9\) olur. En iyi tahmin olan 6 saati geçtik; buna rağmen maliyet \(J(0)=164/3\)'ten \(J(9)=83/3\)'e düştü. \(J'(9)=6\) olduğu için sonraki adım geri yöne gider:
Sonraki adımda yine 6'nın öbür tarafına geçeriz. Parametre iki yanda salınırken 6'ya yaklaşır. En iyi noktayı geçmek tek başına sorun değildir; her geçişten sonra maliyetin düşüp düşmediğine bakmalıyız.
Aynı noktadan \(\eta=1\) ile başlarsak \(c_1=12\), ardından \(c_2=0\) olur. Sonraki adımlarda da 0 ile 12 arasında gidip geliriz; her ikisinin maliyeti \(164/3\). Parametre değişir ama ilerlemez. Kısıtı geçici olarak kaldırıp parabole bütün gerçek sayılarda bakarsak daha büyük oranlarda salınımın büyüdüğünü görürüz. \(\eta=1{,}1\) için ilk adımlar \(c_1=13{,}2\) ve \(c_2=-2{,}64\)'tür. Negatif süre gerçek teslimat probleminde izinli olmadığı için ikinci adım kısıtı da ihlal eder.
Bu Parabolde Eşiği Tam Olarak Bulabiliriz
Bu salınımın sınırlarını formülden bulabiliriz. En iyi tahmin 6; \(c_t\)'nin ona göre işaretli uzaklığına \(e_t=c_t-6\) diyelim. Güncellemede \(J'(c_t)=2(c_t-6)\) yerine koyunca:
6'ya göre işaretli uzaklık her adımda \(1-2\eta\) ile çarpılıyor. Çarpanın mutlak değeri 1'den küçükse uzaklığın büyüklüğü azalır. \(J(c_t)=e_t^2+56/3\) olduğundan minimumun üzerindeki ek maliyet de her adımda \((1-2\eta)^2\) ile çarpılır. Yalnızca bu düzgün parabol için eşikler şunlardır:
- \(0<\eta<0{,}5\): Tahmin 6'ya aynı taraftan yaklaşır.
- \(\eta=0{,}5\): Bu özel parabolde tek adımda tam 6'ya varırız.
- \(0{,}5<\eta<1\): 6'nın iki yanına geçerek yaklaşırız; maliyet yine azalır.
- \(\eta=1\): Uzaklık aynı büyüklükte kalır; iki taraf arasında salınırız.
- \(\eta>1\): Kısıtsız matematiksel uzantıda uzaklık büyür ve yöntem uzaklaşır.
Parabolün eğriliği değişirse bu eşikler de değişir. Çok parametreli modellerde yüzey, farklı yönlerde farklı hızlarda kıvrılabilir. Dolayısıyla listedeki sayıları her maliyet fonksiyonu için öğrenme oranı reçetesi olarak kullanamayız; burada yalnızca oranın adımları nasıl etkilediğini gördük.
Aynı Maliyeti Yeniden Ölçeklersek Ne Değişir?
Üç kareli hatanın ortalaması yerine toplamını kullansaydık \(J_{\text{toplam}}(c)=3J(c)\) olurdu. En iyi tahmin \(c=6\) olarak kalır, türevse üç katına çıkardı:
Aynı sayısal öğrenme oranı artık üç kat büyük bir adım üretir. Ortalama maliyetle attığımız adımı toplam maliyetle tekrarlamak için oranı üçte bire indirmeliyiz. Tek kayıt kaybını, toplamı ve ortalamayı birbirine karıştırırsak öğrenme oranlarını da yanlış karşılaştırırız.
Burada \(c\)'nin birimi saat, \(J\)'nin saat kare, \(J'(c)\)'nin saattir. Bu yüzden \(\eta\)'yı birimsiz düşünebiliriz. Parametrenin veya maliyetin birimini değiştirirsek adımın ölçeği de değişir. Doğru yönde ilerlesek bile farklı birimlerle yazılan parametreler güncellemenin sayısal davranışını etkileyebilir.
Öğrenme Oranını Nasıl Değerlendiririz?
Öğrenme oranını maliyetin ve parametrelerin ölçeğine göre seçeriz. Ölçeği sabit tutup birkaç oranı aynı başlangıç noktasından kısa süre deneyebiliriz. Son değerin yanında eğitim maliyetinin ve parametrelerin adım adım nasıl değiştiğine bakalım. Maliyet hızla yükseliyorsa veya hesap taşacak kadar büyüyorsa oranı küçültmeliyiz. Yerinde sayıyorsa oran küçük olabilir; gradyan da sıfıra yakınsa oranı büyütmek tek başına çözüm olmayabilir.
Eğitim maliyetini hızla düşüren oran, yeni veride en iyi sonucu vermeyebilir. Oranı doğrulama verisiyle seçip son başarı için ayırdığımız test verisini bu seçimin dışında tutmalıyız. Öğrenme oranını eğitim sırasında değiştirmek de mümkündür: Başta büyük, sonra küçük adımlar kullanılabilir. Bunun için ayrı bir kural tanımlamamız gerekir; buradaki sabit \(\eta\) güncellemesi oranı kendiliğinden değiştirmez.
Birden Fazla Ayarda Gradyan Ne Yapar?
Teslimat tahmininde tek ayarımız \(c\) idi. Daha büyük modellerde ağırlık ve kaydırma gibi birçok parametre bulunur. Gradyan ve Kısmi Türevler yazısında her parametrenin maliyete etkisini kısmi türevle ölçüp bir vektörde toplamıştık. Parametrelere \(w\) ve \(b\), onları tutan sütun vektörüne \(\boldsymbol{\theta}=[w,b]^{\mathsf T}\) diyelim. Üstteki \(\mathsf T\), yan yana yazdığımız sayıları alt alta dizer.
Düzgün bir maliyet yüzeyinde gradyan, parametreleri aynı ölçekte değerlendiren standart Öklid uzaklığına göre en hızlı yerel artış yönünü gösterir. Tersi en hızlı yerel azalış yönüdür. Tek değişkenli güncellemeyi bu yüzden vektöre taşıyabiliriz:
İki parametre için kural \(w_{t+1}=w_t-\eta\,\partial J/\partial w\) ve \(b_{t+1}=b_t-\eta\,\partial J/\partial b\) olur. Her iki kısmi türevi de aynı eski \((w_t,b_t)\) noktasında hesaplayıp ayarları birlikte değiştiririz. Önce bir parametreyi güncelleyip ikinci türevi yeni noktadan hesaplamak farklı bir yöntem olur.
İki Kayıtlı Küçük Bir Modeli Eğitelim
\(x\) girdisinden \(\widehat y=wx+b\) tahmini üreten bir model kuralım. \(w\) girdinin etkisini, \(b\) başlangıç düzeyini belirlesin. Eğitim kayıtlarımız \((x_1,y_1)=(0,1)\) ve \((x_2,y_2)=(1,3)\). Model ilk kayıt için \(b\), ikinci kayıt için \(w+b\) tahmin eder. Ortalama kareli maliyet:
Girdiler ve gerçek sonuçlar sabit; ayarladığımız sayılar \(w\) ile \(b\). Her kaydın tahmin hatasını \(e_i=wx_i+b-y_i\) ile gösterelim. \(w\)'deki küçük bir değişim \(e_i\)'yi \(x_i\) katı kadar, \(b\)'deki değişim bir katı kadar etkiler. Hatanın karesinin türevine de zincir kuralıyla ulaşırız:
İki kaybın ortalamasını aldığımız için kısmi türevleri de toplayıp ikiye böleriz. Bu veride sonuç:
\(w_0=0\), \(b_0=0\) ile başlayalım. İki tahmin de sıfır olur; hatalar \(-1\) ve \(-3\), maliyet \(J(0,0)=(1+9)/2=5\)'tir. Bu noktadaki gradyan \([-3,-4]^{\mathsf T}\). \(\eta=0{,}25\) seçip iki ayarı aynı gradyanla güncelleyelim:
Yeni ayarlarla \(x=0\) için 1, \(x=1\) için \(0{,}75+1=1{,}75\) tahmin ederiz. İlk kayıt tam tutar, ikinci kayıtta \(-1{,}25\) hata kalır. Maliyet:
Yeni noktada gradyan \([-1{,}25,-1{,}25]^{\mathsf T}\)'dir. Bir adım daha atınca \(w_2=1{,}0625\), \(b_2=1{,}3125\) buluruz. Artık iki kayıtta da hata vardır, ama ortalama maliyet \(0{,}244140625\)'e düşer. İlk kaydın tahmini biraz bozuldu; yöntem her kaydı ayrı ayrı kusursuz tutmaya değil, ortalama maliyeti azaltmaya çalışıyor.
\(b=1\) ve \(w=2\) seçersek iki kaydı da tam doğru tahmin ederiz; en küçük maliyet sıfır olur. Gradyan inişi bu noktaya yaklaşır. Gerçek verideyse model bütün kayıtları aynı anda açıklayamayabilir, dolayısıyla maliyet sıfıra inmeyebilir.
Çok Kayıt Olduğunda Aynı Hesap
Eğitimde \(m\) kayıt varsa her birinin hatası \(e_i=wx_i+b-y_i\) olur. \(m\) kayıt sayısını gösterir; hataların karelerini ortalarız:
Tek kayıt için bulduğumuz türevleri de aynı biçimde ortalayabiliriz:
Ağırlığa göre türevde her hata kendi girdisi \(x_i\) ile çarpılır. Girdi sıfırsa kayıt \(w\)'nin türevine katkı vermez; \(b\)'nin türevine yine katkı verebilir. Her güncellemede mevcut \(w,b\) ile tahminleri ve hataları yeniden buluruz. Böylece “tahmin et → kaybı ölç → türevleri bul → ayarları güncelle” döngüsünü küçük bir örnekte elle izleyebiliriz.
Şu ana kadar gradyanı bütün \(m\) kayıtla hesapladık. Büyük veri kümelerinde bazen seçilen kayıtlarla yaklaşık gradyan bulunur; adımlar bu yüzden dalgalanabilir. Küçük veri gruplarıyla eğitimi ve başka güncelleme yöntemlerini sinir ağları bölümünde inceleyeceğiz. Adımın yönü, gradyan hesabında kullanılan kayıtlara bağlıdır.
Güncellemeyi Ne Zaman Durdururuz?
Tek parametreli örneğin en iyi noktasını biliyorduk. Gerçek eğitimde çoğu zaman bilmeyiz; bu yüzden her adımdan sonra maliyeti ve parametre değişimini izleriz. Maliyet birkaç adım boyunca çok az değişiyorsa ilerleme yavaşlamış olabilir. Küçük gradyan da yerel eğimin zayıf olduğunu söyler. Bu gözlemler tek başına küresel minimuma ulaştığımızı kanıtlamaz.
Adım sayısına veya hesaplama süresine önceden sınır koyabiliriz. Eğitim maliyeti düşerken yeni kayıtlardaki hata artabilir. Ayarları belirlerken kullanmadığımız doğrulama verisinde hata yükseliyorsa eğitimi sürdürmek yararlı olmayabilir. Son başarıyı ayrı test verisinde ölçmeliyiz.
Yöntemin Sınırları Nerede?
Gradyan bize bulunduğumuz yerin eğimini verir. Tek çukurlu parabolde uygun öğrenme oranıyla en iyi noktaya yaklaştık; birden fazla çukuru olan yüzeyde başlangıç noktasına göre farklı yerel minimumlara varabiliriz. Gradyanın sıfır olduğu nokta maksimum veya eyer de olabilir. Düz bir bölgede çok küçük gradyanla ilerlemek de yavaşlayabilir.
Türev her noktada yoktur. Önceki yazıdaki mutlak hata, tahminin gözlenen değere eşit olduğu köşelerde klasik anlamda türevlenmez. Böyle bir noktada hangi yönde ilerleyeceğimizi ayrıca tanımlamamız veya tek yanlı eğimlere bakmamız gerekir. Buradaki temel güncellemeyi düzgün maliyet fonksiyonları için kurduk.
Kısıt varsa güncelleme izinli alanın dışına çıkabilir. Teslimat süresi için \(c\geq0\) gerekir; önceki \(0\leq c\leq5\) kısıtında ise kısıtsız en iyi değer olan 6 zaten kullanılamaz. Sınırı aşan adım için ayrıca bir yöntem tanımlamalıyız. Tek aralıkta yeni değeri en yakın izinli noktaya çekebiliriz; bu, yalın gradyan inişine ek bir işlemdir.
Girdilerin ölçeği de adımları etkiler. Bir özellik metre, diğeri binlerce lira cinsindeyse aynı sayısal öğrenme oranı parametre yönlerinde farklı büyüklükte değişimler yaratabilir. Girdileri gerektiğinde ölçeklemek eğitimi kolaylaştırabilir. Ölçekleme değerlerini doğrulama veya test kayıtlarından öğrenirsek veri sızıntısına yol açarız.
Gradyan İnişinde Sık Yapılan Hatalar
- Gradyanın yönüne yürümek: Gradyan yerel artışı gösterir; maliyeti azaltmak için eksi işaretini kullanırız.
- Öğrenme oranını doğrudan adım mesafesi sanmak: Değişim \(-\eta\nabla J\)'dir; gradyanın büyüklüğü de adımı belirler.
- Her adımda aynı eski eğimi kullanmak: Parametreler değişince tahmin, hata ve gradyan yeniden hesaplanır.
- Çok parametreli güncellemeyi yanlış sırayla yapmak: Standart eşzamanlı kuralda bütün kısmi türevler aynı eski parametre vektöründe değerlendirilir.
- Tek bir öğrenme oranını evrensel saymak: Maliyeti toplam veya ortalama yazmak bile aynı sayısal oranın etkisini değiştirir.
- Minimumu yalnızca sıfır gradyanla tanımlamak: Eyer, maksimum, köşe veya kısıt sınırı ayrı değerlendirilmelidir.
- Azalan eğitim maliyetini genel başarı saymak: Yeni verideki hata ayrıca ölçülmelidir.
Bir Güncellemeyi Okurken İzlenecek Yol
- Parametreleri ve maliyeti yazın. Hangi sayılar değişiyor, tek kayıt kaybı nasıl ortalanıyor, hangi kısıtlar geçerli?
- Mevcut noktada tahmin ve hatayı hesaplayın. Gradyanın hangi veri ve parametre değerlerinden geldiğini görün.
- Türevleri doğru sırada bulun. Her kısmi türevi aynı mevcut noktada değerlendirin; gerekirse zincir kuralını açıkça izleyin.
- İşareti ve adım büyüklüğünü kontrol edin. Güncelleme \(-\eta\nabla J\) yönündedir; kısıt varsa yeni noktayı ayrıca denetleyin.
- Yeni maliyeti yeniden hesaplayın. Yerel yön bilgisi, büyük bir adımın gerçekten maliyeti düşürdüğünü garanti etmez.
- Eğitim ve yeni veri sonuçlarını ayırın. Öğrenme sürecini eğitim maliyetiyle izleyin; kullanılabilirliği ayrı veride değerlendirin.
Sonuç: Eğimden Öğrenme Adımına
Maliyet fonksiyonu her ayarın bedelini verir. Türev ve gradyan, ayarı biraz değiştirdiğimizde bu bedelin hangi yönde değişeceğini gösterir. Gradyan inişinde yerel artış yönünün tersine ilerler, yeni noktada eğimi yeniden hesaplarız. Öğrenme oranı adımı ölçekler; adımın gerçek büyüklüğü gradyana da bağlıdır.
Teslimat örneğinde \(c=0\)'dan başlayıp 6 saate yaklaştık. Küçük öğrenme oranıyla yavaş ilerledik; daha büyük bir oranla hedefin iki yanına geçerek yaklaşabildik. Oran fazla büyüdüğünde ise ilerleme durdu ya da tersine döndü. Bu davranışın tam eşiklerini yalnızca örneğimizdeki parabol için bulduk. İki kayıtlı modelde \(w\) ve \(b\) parametrelerini birlikte güncelleyince ortalama maliyet 5'ten 0,78125'e, ardından yaklaşık 0,24414'e indi.
Büyük modellerde bütün ayarları tek tek denemek veya her adımda bütün veriyi kullanmak pahalı olabilir. Sıradaki Monte Carlo Yöntemleri yazısında rastgele örnekleme yoluyla hesaplanması güç büyüklükleri nasıl yaklaşık bulabileceğimizi inceleyeceğiz. Kontrollü örneklemenin ne sağladığını orada daha yakından göreceğiz.
Yazar: Levent KARAGÖL