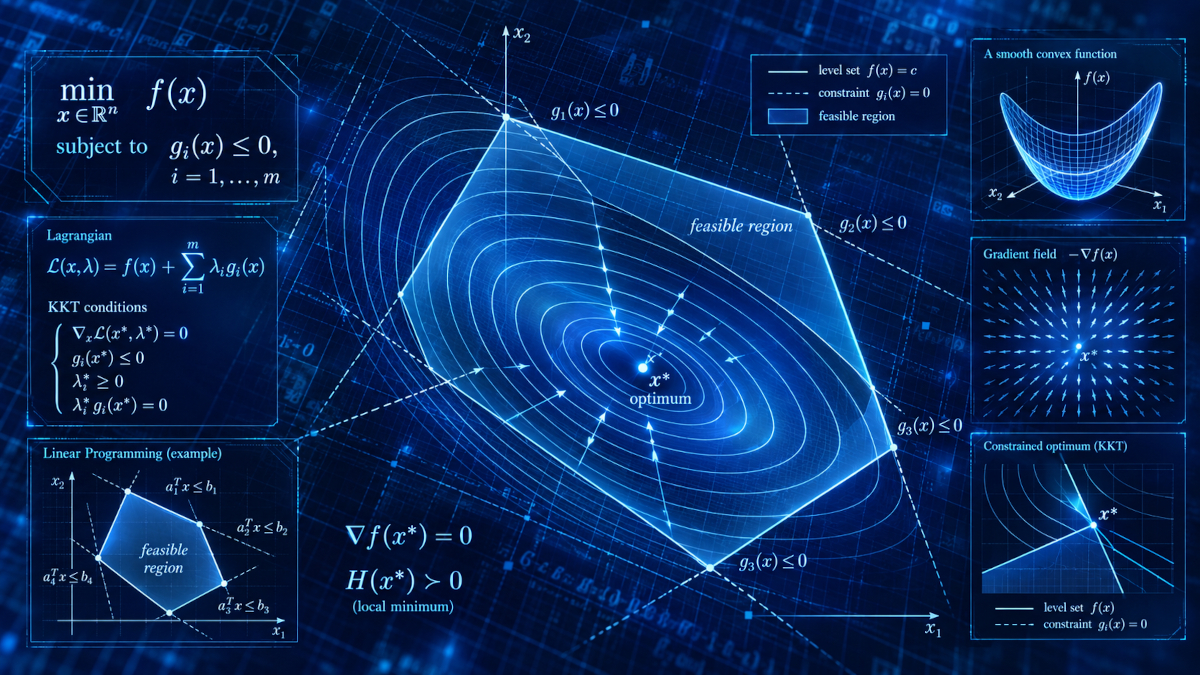
Bir modelin hatasını ölçtükten sonra hangi ayarların bu hatayı azaltacağını bulmamız gerekir. İzin verilen seçenekler arasından amacımıza en uygun olanı aramaya optimizasyon, amacı sayıyla ifade eden kurala maliyet fonksiyonu deriz. Bir teslimat süresi tahmininden başlayıp kareli ve mutlak hatanın neden farklı seçimlere götürdüğünü hesaplayacağız. Ardından çapraz entropiyi bu çerçevede kullanacak ve düşük eğitim maliyetinin sınırlarını inceleyeceğiz.
Hatayı Ölçtük; Şimdi Hangi Sayıyı Seçeceğiz?
Bir kargo şirketinde teslimat süresini tahmin ettiğimizi düşünelim. Önceki üç teslimat 2, 4 ve 12 saat sürmüş. Adres, trafik veya mesafe bilgimiz yok; her yeni teslimat için aynı süreyi söyleyeceğiz. Bu süre 4 saat mi olmalı, 6 saat mi?
Veri listesi tek başına karar verdirmez. İyi tahminin ne olduğunu da söylemeliyiz: Büyük bir yanılmaya daha ağır bedel mi vereceğiz, yoksa her ek saatlik sapmayı aynı mı sayacağız? Aynı üç teslimat, seçtiğimiz ölçüye göre farklı tahminler doğurabilir.
Çapraz Entropi ve KL Iraksaması yazısında olasılık tahmininin bedelini hesaplamıştık. Şimdi model ayarlarını bu bedeli düşürecek biçimde seçeceğiz. Bu arayışa optimizasyon (optimization), neyi küçültmek istediğimizi sayıyla belirleyen kurala amaç fonksiyonu (objective function) denir.
Bir Optimizasyon Sorununun Dört Parçası
Bütün teslimatlar için söyleyeceğimiz süreye \(c\) diyelim. \(c=4\) seçersek dört, \(c=6\) seçersek altı saat tahmin ederiz. Bu sayı modelin parametresidir: Onu değiştirdiğimizde tahmin de tahminin bedeli de değişir.
- Seçilecek şey: Bu örnekte \(c\) parametresi. Daha büyük bir modelde çok sayıda ağırlık ve kaydırma birlikte seçilir.
- İzin verilen seçenekler: Teslimat süresi negatif olamayacağı için örneğin \(c\geq0\) koşulunu koyabiliriz. Başka bir problemde bellek, bütçe veya güvenlik sınırı bulunabilir.
- Ölçü: Her \(c\) değerinin ne kadar iyi olduğunu tek bir sayıyla anlatan maliyet fonksiyonu.
- Yön: Bedeli en aza indirmek ya da bir yararı en çoğa çıkarmak.
Bir maliyet fonksiyonunu \(J(c)\) ile gösterirsek “en düşük maliyeti veren \(c\)'yi bul” isteğini şöyle yazabiliriz:
\(J(c)\), seçtiğimiz \(c\)'nin maliyetidir. \(\arg\min\), “en küçük maliyeti veren girdiyi bul” diye okunur. Yıldızlı \(c^{*}\) bu girdiyi, \(J(c^{*})\) ise onun maliyetini gösterir. Birden fazla \(c\) aynı en düşük maliyeti verirse birden fazla en iyi çözüm vardır.
Her zaman maliyet küçültmeyiz; kimi zaman kazancı büyütmek isteriz. \(R(c)\) adlı getiriyi en çoğa çıkarmak, \(-R(c)\)'yi en aza indirmekle aynı adayı seçer. İşaret aramanın yönünü değiştirir; ölçtüğümüz amaç aynı kalır. Bütün aday maliyetlerini pozitif bir sayıyla çarpmak da en iyi adayı değiştirmez, yalnızca maliyetin ölçeğini değiştirir.
Tek Tahminin Kaybından Veri Kümesinin Maliyetine
Bir model çoğu zaman tek bir kayıtla değil, birçok kayıtla eğitilir. Her kayıtta gerçekleşen sonuca \(y_i\), modelin o kayıt için verdiği tahmine \(\widehat y_i\) diyelim. Alt indis olan \(i\), kaydın listedeki sırasını gösterir. Gerçek değer ile tahmin arasındaki fark \(e_i=\widehat y_i-y_i\) olsun; işaretin yönünü böyle seçiyoruz. Mutlak değer veya kare kullandığımızda ters işaret seçimi sonucu değiştirmez.
Tek bir kaydın bedelini hesaplayan kurala kayıp fonksiyonu (loss function) diyelim ve \(\ell(y_i,\widehat y_i)\) ile gösterelim. \(m\) kayıt varsa bu kayıpların ortalamasını eğitim maliyeti olarak kullanabiliriz:
\(\theta\) (“teta”) ayarlanabilir parametrelerin tümünü gösterir; ilk örneğimizde yalnızca \(c\)'dir. \(\widehat y_i(\theta)\), seçilen parametrelerle \(i\)'inci kayıt için yapılan tahmindir. Kayıpları toplayıp \(m\)'ye bölerek kayıt başına ortalamayı buluruz. Kaynaklar “kayıp” ve “maliyet” sözcüklerini bazen eş anlamlı kullanır. Burada tek kayıt için kayıp, kayıtları birleştiren amaç fonksiyonu için maliyet diyeceğiz.
Eğitim verisi aynı kalırken \(\theta\)'yı değiştirirsek her ayar kümesi için başka bir maliyet buluruz. Fonksiyonlar yazısındaki girdi–kural–çıktı ilişkisi burada da geçerli. Modelin bütün kayıtlara aynı tahmini vermesi gerekmez; ileride her kaydın özelliklerini de \(\widehat y_i(\theta)\) hesabına katacağız.
Teslimat Sürelerini Kareli Hata ile Ölçelim
Teslimatlar \(2,4,12\) saat sürdü; hepsine \(c\) saat diyeceğiz. Önce tahmin ile gerçek süre arasındaki farkı kareleyelim. Böylece eksi ve artı hatalar birbirini götürmez, büyük sapmalar daha ağır sayılır. Üç kayıt için karelerin ortalaması ortalama kare hata (mean squared error, MSE) olur:
\(c=4\) seçersek hatalar sırasıyla \(2,0,-8\) saat olur. Kareleri \(4,0,64\); toplam \(68\), ortalama \(68/3\approx22{,}67\) saat karedir. \(c=6\) için hatalar \(4,2,-6\), kareleri \(16,4,36\) ve ortalama \(56/3\approx18{,}67\) saat karedir. Kareli hataya göre altı saatlik tahmin daha iyidir.
| Ortak tahmin | Hataların kareleri | Ortalama kare hata |
|---|---|---|
| \(c=4\) saat | \(4,0,64\) | \(68/3\approx22{,}67\ \text{saat}^2\) |
| \(c=6\) saat | \(16,4,36\) | \(56/3\approx18{,}67\ \text{saat}^2\) |
\(c=6\) yalnızca bu iki adayın en iyisi mi, yoksa bütün seçeneklerin en iyisi mi? Kareleri açalım:
Son satırda \(c^2-12c\) ifadesini \((c-6)^2-36\) biçiminde yazdık; bu işleme kare tamamlama denir. \((c-6)^2\) negatif olamaz ve yalnızca \(c=6\)'da sıfırlanır. Dolayısıyla izinli \(c\geq0\) değerlerinde en küçük maliyet \(56/3\), onu veren tek tahmin 6 saattir. Teslimatların ortalaması da \((2+4+12)/3=6\). Sabit bir tahminle kareli hatayı en aza indirdiğimizde aritmetik ortalamayı bulmamızın nedeni budur. Bu bağlantıyı Beklenen Değer ve Varyans ve Korelasyon ve Regresyon Analizi yazılarında da görmüştük.
En küçük maliyet yine de sıfır değil. Tek bir sabit sayı 2, 4 ve 12 saatlik teslimatların hepsini doğru tahmin edemez. Optimizasyon, seçtiğimiz model ve ölçü için en iyi ayarı bulur; elimizde olmayan adres veya trafik bilgisini sağlamaz.
Aynı Veriye Bu Kez Mutlak Hata ile Bakalım
Bir saatlik yanılmaya bir birim, sekiz saatlik yanılmaya sekiz birim bedel vermek istiyorsak farkların mutlak değerini kullanabiliriz. Ortalama mutlak hata (mean absolute error, MAE) şöyledir:
Aynı tahminleri mutlak hatayla ölçelim. \(c=4\) için hatalar \(2,0,8\), ortalama \(10/3\approx3{,}33\) saattir. \(c=6\) için hatalar \(4,2,6\), ortalama 4 saattir. Bu ölçü dört saatlik tahmini seçer.
| Ortak tahmin | Mutlak hatalar | Ortalama mutlak hata |
|---|---|---|
| \(c=4\) saat | \(2,0,8\) | \(10/3\approx3{,}33\) saat |
| \(c=6\) saat | \(4,2,6\) | \(4\) saat |
Dört saat bütün olası tahminler arasında da en iyisidir. \(c\)'yi 2 ile 4 arasında sağa kaydırırsak 2'ye uzaklık artar, 4'e ve 12'ye uzaklık azalır; toplam düşer. \(c\)'yi 4 ile 12 arasında sağa kaydırdığımızdaysa 2'ye ve 4'e uzaklık artar, yalnızca 12'ye uzaklık azalır; toplam yükselir. Yönün değiştiği 4, verinin ortancasıdır (medyan). Tek sayıda gözlem için mutlak hatayı en aza indiren sabit tahmin ortancadır. Gözlem sayısı çiftse ortadaki iki değer arasındaki bütün sayılar en küçük toplamı verebilir.
On iki saatlik teslimat diğerlerinden uzun. Dört saatlik tahminde bu gözlemin hatası MSE hesabına \(8^2=64\), MAE hesabına 8 olarak girer. MSE'nin tahmini 6'ya çekip MAE'nin 4'te bırakması bu farktan kaynaklanır. Yine de 12 saati “yanlış veri” diye atamayız; gerçek bir teslimat olabilir. Ölçü seçimi, sekiz saatlik yanılmanın işteki karşılığına bağlıdır.
İyi Bir Maliyet Fonksiyonu Neyi Yansıtmalı?
MSE büyük sapmalara ağır bedel verir ve bu örnekte türevle inceleyebildiğimiz düzgün bir parabol oluşturur. MAE her ek saatlik hataya aynı bedeli verir; \(c=y_i\) gibi köşelerde klasik türevi yoktur. Hesaplaması kolay olanı seçmeden önce modelin hangi yanılmaları azaltmasını istediğimizi belirlemeliyiz.
Geç teslimat müşteriye erken teslimattan daha pahalıya mal oluyorsa iki yöndeki hataya farklı bedel vermek isteyebiliriz. Hasta bir kişiyi sağlıklı sanmakla sağlıklı bir kişiyi hasta sanmak da aynı sonuçları doğurmaz. Kayıp fonksiyonunu seçerken önce bu kararların gerçek bedeline bakmalıyız.
Modeli eğitirken kullandığımız amaç ile başarısını anlattığımız ölçüt farklı olabilir. Kareli hatayı küçülterek eğitilen bir modelin sonucunu, kullanıcı için anlaşılır olan RMSE ile raporlayabiliriz. Sınıflandırıcıyı çapraz entropiyle eğitip doğru sınıf seçme oranını ayrıca ölçebiliriz. Eğitim amacı ayarları seçer; raporladığımız ölçüt sonucun belirli bir açıdan nasıl göründüğünü anlatır. Ölçütü görevin gerçek maliyetlerine göre seçmeliyiz.
Olasılık Tahmininde Amaç: Çapraz Entropiyi Küçültmek
Teslimatta saat cinsinden bir sayı tahmin ettik. Sınıflandırmada ise model olası sonuçlara pay dağıtır. Önceki yazıdaki kutudan dört kez bilye çekmiş, üç kırmızı ve bir mavi görmüştük. Model kırmızıya \(q\), maviye \(1-q\) payı versin. İki renk de veride bulunduğundan \(0<q<1\) seçiyoruz; herhangi birine sıfır vermek kaybı sonsuza götürür.
Gerçekleşen sonuca verilen payın negatif doğal logaritmasını tek çekilişin kaybı olarak alalım. Dört çekilişin ortalaması:
Her kırmızı çekilişin bedeli \(-\ln q\), mavininki \(-\ln(1-q)\) olduğu için formülde 3 ve 1 katsayıları var. Gözlenen oranlarla hesapladığımız bu değer ampirik çapraz entropidir. Önceki yazıda 2 tabanlı logaritmayla bit cinsinden hesap yapmıştık. Burada doğal logaritma kullandığımız için birim nat/gözlem. Tabanı değiştirmek bütün değerleri pozitif bir çarpanla ölçekler; en iyi \(q\) değişmez.
| Kırmızıya verilen pay | Dört gözlemin ortalama kaybı |
|---|---|
| \(q=0{,}50\) | \(\approx0{,}693\) nat/gözlem |
| \(q=0{,}75\) | \(\approx0{,}562\) nat/gözlem |
| \(q=0{,}90\) | \(\approx0{,}655\) nat/gözlem |
Kırmızıya verilen payı \(0{,}75\)'e çıkarmak kaybı azalttı, \(0{,}90\)'a çıkarmaksa artırdı. İkinci durumda maviye yalnızca \(0{,}10\) kalıyor ve gerçekleşen mavi çekiliş pahalıya mal oluyor. Bu veri için bütün \(0<q<1\) seçenekleri arasında en düşük ortalama kayıp \(q=3/4\)'te. Türev de aynı sonucu verir:
\(q<3/4\) iken türev negatif, \(q>3/4\) iken pozitiftir; maliyet önce düşer, sonra yükselir. Olabilirlik ve Parametre Tahmini yazısındaki gibi log-olabilirliği en çoğa çıkarmakla negatif log-olabilirliği en aza indirmek aynı parametreyi seçer. Burada hesapladığımız kayıp, negatif log-olabilirliğin kayıt başına ortalamasıdır.
Dört gözlemde kırmızı oranı \(3/4\) çıktı; kutunun gerçek uzun dönem oranının da \(3/4\) olduğunu bundan kesin olarak bilemeyiz. Gerçek \(P\) bilinseydi beklenen çapraz entropiyi \(H(P,Q)=H(P)+D_{\mathrm{KL}}(P\parallel Q)\) diye ayırabilirdik. \(H(P)\) model ayarından bağımsızdır; ayarlarla değişen ek bölüm KL ıraksamasıdır. Elimizdeyse çoğunlukla gerçek \(P\) yerine sınırlı veri vardır. Model ailesi gerçek dağılımı temsil edemiyorsa beklenen kaybın en düşük değeri de \(H(P)\)'nin üzerinde kalabilir.
Bir Parametreden Çok Sayıda Ayara
Teslimat örneğinde tek ayarımız \(c\) idi; bütün kayıtlar aynı tahmini aldı. Mesafeyi bilseydik \(x\) kilometre için \(\widehat y=wx+b\) kuralını kullanabilirdik. \(w\), mesafe bir birim arttığında tahminin ne kadar değişeceğini; \(b\), başlangıç değerini belirler. Şimdi \((w,b)\) ikilisini seçmemiz gerekir. Her kaydın \(x_i\) değerini yerine koyup kayıpları hesaplar ve ortalarız:
Bu formül, regresyon yazısındaki en küçük kareleri parametreler üzerinden gösterir. Tek parametreli maliyetin grafiği bir eğri, iki parametrelininki bir yüzey olur. Parametreler çoğaldığında grafiği çizmek zorlaşır; ama her ayar kümesinin bir maliyeti vardır. Gradyan ve Kısmi Türevler yazısındaki gradyan, maliyetin parametrelerin her birine göre yerel değişimini bir vektörde toplar.
Bazı kayıtların ölçümü daha güvenilir, bazı hataların bedeli daha yüksek olabilir. Böyle bir gerekçemiz varsa kayıplara farklı ağırlıklar verebiliriz. Ağırlıkları \(a_i\geq0\), toplamlarını \(\sum_i a_i>0\) seçtiğimizde ağırlıklı ortalama \(\sum_i a_i\ell_i/\sum_i a_i\) olur. Ağırlıklar en iyi parametreyi değiştirebileceği için neden seçildiklerini açıkça belirtmeliyiz.
Maliyete Başka Bir Koşul Eklemek: Düzenlileştirme
Çok esnek bir model eğitim kayıtlarına fazla uyup yeni kayıtlarda kötü tahminler verebilir. Bunu sınırlamak için parametrelerin aşırı büyümesine de bedel koyabiliriz. Bu ek bedele düzenlileştirme (regularization) terimi denir:
\(J_{\text{veri}}\) tahminlerin gözlemlere uyumunu, \(R(\theta)\) ise seçtiğimiz parametre özelliğinin bedelini ölçer. Örneğin ağırlık vektörü \(\mathbf{w}\) için \(R(\theta)=\lVert\mathbf{w}\rVert_2^2\), ağırlıkların karelerini toplar. Bu tür bir terim büyük ağırlıkları daha pahalı kılar. \(\lambda\) sıfırsa ek bedel yoktur; büyüdükçe ek bedelin seçim üzerindeki etkisi artar. Kaydırma parametresini \(b\) cezaya katıp katmamak ayrı bir modelleme tercihidir; kullanılan tanım açıkça belirtilmelidir.
Veri kaybını toplam yerine ortalama yazmak \(\lambda\)'nın göreli gücünü değiştirir. \(J_{\text{veri}}\) ile \(R\)'nin birimleri farklıysa \(\lambda\) da uygun birim taşımalıdır. MLE ile MAP yazısında bazı düzenlileştirme biçimlerinin önsel bilgiyle ilişkisini görmüştük. Burada veriye uyumla parametre tercihini aynı amaçta açıkça birleştiriyoruz. Ek terim tek başına yeni veride başarı garantisi vermez.
En İyi Nokta Her Zaman İçeride mi?
\(J_{\mathrm{MSE}}(c)=(c-6)^2+56/3\) ifadesi en küçük değerini \(c=6\)'da alıyordu. Şirketin sistemi en fazla beş saatlik tahmin göstermeye izin verse seçenekler \(0\leq c\leq5\) aralığıyla sınırlanır. Bu sınırı matematiksel kısıtın etkisini görmek için koyduk; gerçek uygulamada uygun olması gerekmez.
Altı artık izinli değildir. \(c\), 0'dan 5'e doğru yaklaştıkça \((c-6)^2\) küçülür; dolayısıyla izin verilen aralıkta en iyi seçim sınırdaki \(c=5\)'tir:
Sınırdaki en iyi noktada türev sıfır olmak zorunda değil: Burada \(J'_{\mathrm{MSE}}(5)=2(5-6)=-2\). Sağa ilerlemek maliyeti azaltırdı, ancak izinli alanın dışına çıkar. Türev yazısında da kritik noktalarla aralık uçlarını birlikte incelemiştik. Kısıtlı problemde yalnızca türevi sıfıra eşitlemek yetmez.
Bir Çukurun Dibi mi, Bütün Arazinin En Dibi mi?
Teslimat örneğindeki kareli maliyetin grafiği tek çukurlu bir paraboldür. \(c=6\), çevresindeki ve izinli alanın tamamındaki değerlerden daha düşük maliyet verir. Bütün alandaki en iyi noktaya küresel minimum (global minimum), yalnızca yakın çevresindekilerden daha iyi olana yerel minimum (local minimum) denir. Engebeli bir arazide bir çukurun dibine inmek, en derin çukuru bulduğumuz anlamına gelmez.
Sıfır türev de tek başına minimumu göstermez. \(f(x)=x^3\) için \(f'(0)=0\), fakat fonksiyon sıfırın iki yanında artmayı sürdürür. \(|x|\) ise en küçük değerini sıfırda alır; orada klasik türevi yoktur. Adayları incelerken maliyetin şeklini ve izinli alanı birlikte düşünmeliyiz. Karmaşık modellerde bütün grafiği çizmek ya da her ayarı tek tek denemek çoğu zaman mümkün değildir.
Bazen maliyet bir sınıra yaklaşır ama en küçük değerini almaz. Yalnızca \(c>0\) değerlerine izin verip \(J(c)=c\) seçersek sıfıra istediğimiz kadar yaklaşabiliriz. Ancak \(c=0\) izinli değildir; dolayısıyla en küçük değeri veren bir \(c^{*}\) yoktur. Yaklaşmak ile ulaşmak arasındaki fark burada belirleyicidir.
Düşük Eğitim Maliyeti Neyi Kanıtlamaz?
Dört bilye çekilişinde \(q=0{,}75\) eğitim verisinin en iyi sabit olasılık tahminiydi. Sonraki dört çekilişte aynı oranı görmeyebiliriz. Benzer biçimde 2, 4 ve 12 saatlik teslimatlardan seçtiğimiz en iyi sabit \(c\), yarının trafiğinde en iyi tahmin olmayabilir. Bulduğumuz sonuç seçilen veriye, model ailesine, maliyete ve kısıtlara bağlıdır.
Daha karmaşık bir model eğitim kayıtlarını neredeyse ezberleyebilir. Eğitim maliyeti düşerken yeni veride hata artıyorsa buna aşırı uyum (overfitting) deriz. Model seçimini eğitimden ayrı doğrulama verisiyle, son performansı da ayrı test verisiyle değerlendirmeliyiz. Eğitim ve test kayıtları birbirinin kopyasıysa veya zaman, kişi ya da kaynak ilişkileri iki kümeye sızmışsa bu ayrım da yanıltıcı sonuç verebilir.
Düşük çapraz entropi, gerçek etiketlere daha yüksek olasılık verilmesiyle ilgilidir. Doğru sınıfın her zaman seçildiğini, olasılıkların iyi kalibre edildiğini ya da bir dil modelinin doğru bilgi verdiğini göstermez. Düşük kareli hata da bütün alt gruplarda adil veya güvenli sonuç alındığı anlamına gelmez. Kullanım için önemli olan sonuçları ayrıca ölçmeliyiz.
Maliyet Fonksiyonlarında Sık Yapılan Hatalar
- Ölçüyü seçmeden “en iyi” demek: Aynı teslimat verisinde MSE'nin seçtiği 6 saat ile MAE'nin seçtiği 4 saat farklıdır. Önce hangi yanılmaların ne kadar önemli olduğunu belirtmeliyiz.
- Kayıp ile maliyeti karıştırmak: Tek kaydın \(\ell_i\) kaybı ile bütün kayıtların ortalaması \(J\) ayrı düzeylerdir. Toplam mı ortalama mı kullandığımızı da söylemeliyiz.
- Parametreyi minimum değer sanmak: \(c^{*}=6\) en iyi tahmindir; \(J(c^{*})=56/3\) ise o tahminin MSE maliyetidir.
- Birimleri unutmak: Saat cinsindeki MAE ile saat kare cinsindeki MSE aynı ölçekte değildir. Maliyetler farklı veri kümelerinde veya farklı normalleştirmelerle de doğrudan karşılaştırılamaz.
- Logaritmanın tabanını veya sıfırları atlamak: Bit ile nat dönüştürülmelidir. Gerçekte görülen sonuca sıfır pay vermek çapraz entropide sonsuz bedel yaratır.
- Her sıfır türevi çözüm sanmak: Yatay nokta minimum olmayabilir. Köşe noktası veya kısıt sınırı da en iyi seçim olabilir.
- Eğitim maliyetini gerçek başarı saymak: Daha küçük eğitim maliyeti, yeni kayıtlarda daha küçük hata veya başka bir iş ölçütünde iyileşme garantisi değildir.
Bir Optimizasyon Sorusu İçin Kısa Kontrol Yolu
- Seçimi adlandırın. Hangi sayı veya parametreler değişebilir, hangileri veri olarak sabittir?
- İzin verilen alanı yazın. Olasılık, süre, bütçe ve diğer sınırlar adayları nasıl daraltıyor?
- Tek kaydın bedelini açıklayın. Mutlak fark, kareli fark veya negatif logaritma gerçek amaçla nasıl ilişkili?
- Kayıpları nasıl birleştirdiğinizi belirtin. Sabit bir veri kümesinde toplam ile ortalama aynı adayı seçer; kayıtları farklı ağırlıklandırmak seçimi değiştirebilir.
- Adayları hesaplayıp sınırları denetleyin. Türev, tablo veya cebir yardımcı olabilir; köşeler ve aralık uçları unutulmamalı.
- Sonucu iki sayı olarak okuyun. Hangi parametre seçildi ve o parametrede maliyet kaç oldu?
- Yeni veride yeniden sorun. Eğitimde düşük bedel, amaçlanan kullanımda da iyi sonuç veriyor mu?
Sonuç: Öğrenmenin Hedefini Açıkça Koymak
Optimizasyon sorusunda önce değişebilen ayarları, izinli seçenekleri ve küçültmek ya da büyütmek istediğimiz ölçüyü belirleriz. Maliyet fonksiyonu her seçeneğe karşılaştırabileceğimiz bir sayı verir. Tek kayıt kayıplarını bütün veride birleştirince model parametreleri için amaç fonksiyonunu elde ederiz.
Üç teslimatın süresinde kareli hata 6 saatlik ortalamayı, mutlak hata 4 saatlik ortancayı seçti. Aynı veri için “en iyi” tahmin, hataya verdiğimiz bedele göre değişti. Bilye örneğinde gerçekleşen sonuca verilen olasılığın negatif logaritmasını ortalayarak çapraz entropiyi maliyet yaptık. Kısıtlar ve düzenlileştirme bu seçimi değiştirebilir; yeni verideki ölçümse sonucun ne kadar işe yaradığını gösterir.
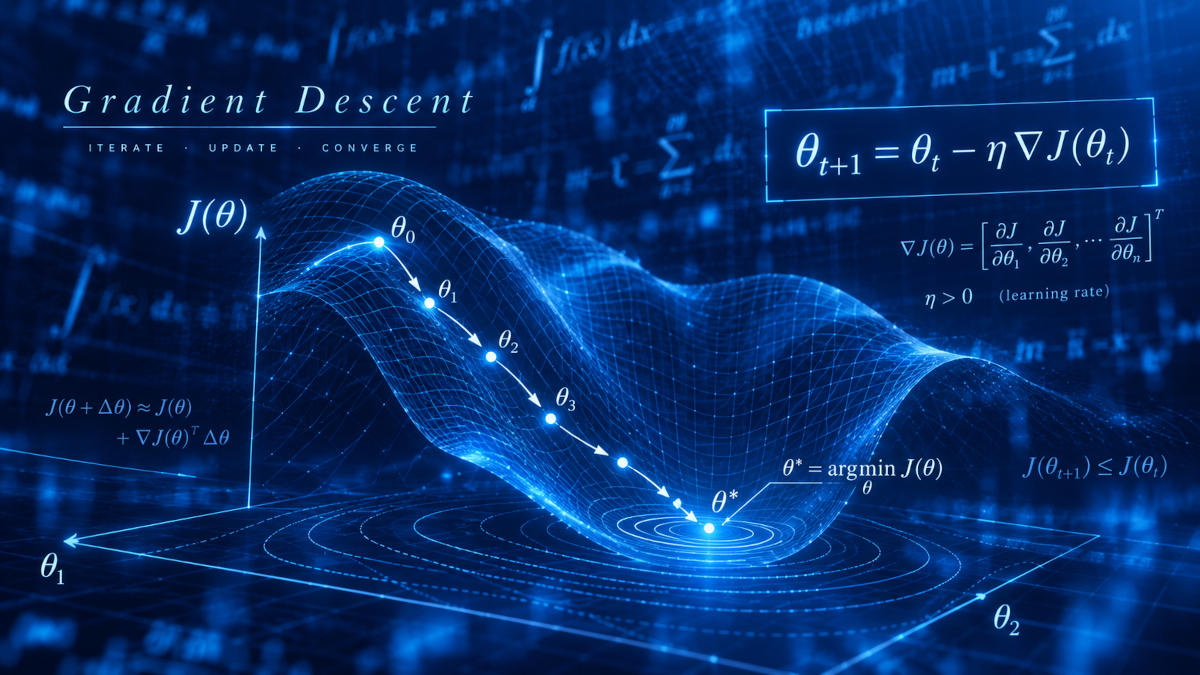
Küçük örneklerde en iyi ayarı kare tamamlayarak veya türevi sıfıra eşitleyerek bulduk. Parametreler çoğaldığında, maliyetin formülünü bilsek bile çözümü doğrudan bulamayabiliriz. Sıradaki Gradyan İnişi (Gradient Descent) ve Öğrenme Oranı (Learning Rate) yazısında bulunduğumuz ayarlardan başlayıp gradyanın gösterdiği yerel yönde adım atarak maliyeti nasıl düşürmeye çalışacağımızı inceleyeceğiz.
Yazar: Levent KARAGÖL