Bir olasılığı, ortalamayı veya integrali doğrudan hesaplamak güçse rastgele seçilmiş örneklerden yaklaşık bir değer bulabiliriz. Monte Carlo yöntemleri bu fikre dayanır. Aynı yaklaşım, bir yapay zekâ modelinin farklı durumlardaki ortalama hatasını tahmin etmemize de yardım eder. Zar ve alan örnekleriyle başlayıp örnek ortalamasının neden işe yaradığını, hatasını nasıl ölçtüğümüzü, hangi varsayımlarda yanıltıcı olabileceğini ve model eğitiminde neyi yaklaşık hesapladığımızı inceleyeceğiz.
Her Olasılığı Tek Tek Hesaplamak Zorunda mıyız?
Bir kargo şirketi yarınki gecikme oranını merak etsin. Teslimat süresini trafik, hava durumu, mesafe ve o günkü iş yükü etkiler; bunların bütün birleşimlerini tek tek hesaplamak zor olabilir. Olası durumları temsil eden bir düzenden tekrar tekrar örnek seçebilirsek geciken teslimatların payıyla yaklaşık bir olasılık buluruz.
Gradyan İnişi yazısında bütün kayıtların maliyetini ve gradyanını her adımda hesaplamanın pahalı olabileceğini görmüştük. Bazen seçilen kayıtlarla bütüne ilişkin bir tahmin yapabiliriz. Bunun güvenilirliği, kayıtları nasıl seçtiğimize bağlıdır.
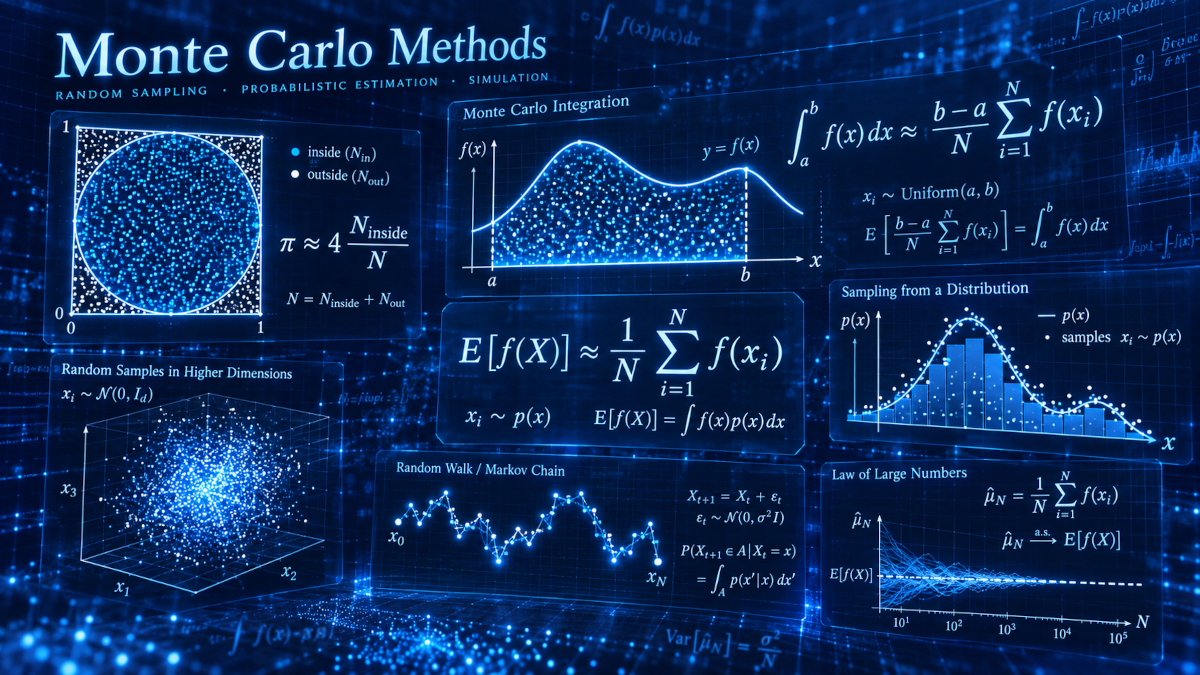
Monte Carlo yöntemi (Monte Carlo method), rastgele denemelerden sayısal bir büyüklük tahmin eden yöntemler ailesidir. Önce neyi hesaplamak istediğimizi ve örnekleme kuralını belirleriz. Ardından uygun dağılımdan örnekler üretip katkılarını birleştiririz. Rastgelelik burada hesaplama aracıdır.
Önce Kontrol Edebileceğimiz Bir Zar Sorusu
İki adil zar attığımızda toplamın en az 10 gelme olasılığı nedir? Temel Olasılık Kavramları yazısındaki eş olasılıklı sonuçları kullanırsak bunu tam olarak sayabiliriz. Zarların sırası ayrı sonuçlar oluşturur; toplam \(6\cdot6=36\) sıralı sonuç vardır. Uygun olanlar \(10\) için \((4,6),(5,5),(6,4)\); \(11\) için \((5,6),(6,5)\); \(12\) için \((6,6)\) olmak üzere altı tanedir.
Cevabı sayarak bulamadığımızı varsayalım. Her denemede iki adil zar atıp toplam en az 10 ise 1, değilse 0 kaydederiz. Olası bir 12 denemelik dizide toplamlar \(3,10,8,7,11,4,6,9,12,5,8,7\) olsun. \(10,11,12\) toplamlarını gördük; olay 12 denemede üç kez gerçekleşti.
Şapkalı \(\widehat p\), bilinmeyen \(p\) olasılığı için örneklerden bulduğumuz tahmindir. Bu dizide \(0{,}25\) bulduk; gerçek değer yaklaşık \(0{,}1667\). Başka 12 deneme başka sonuç verebilir. Zar sorusunun tam cevabını bildiğimiz için örneklemenin nasıl davrandığını kontrol edebiliyoruz.
Saymanın Genel Kuralı: Gösterge Değişkeni
Bir olayın her denemedeki kaydına \(Z_i\) diyelim. Buradaki \(i\), denemenin sıra numarasıdır. Olay gerçekleştiğinde \(Z_i=1\), gerçekleşmediğinde \(Z_i=0\) olur. Böyle bir sayıya gösterge değişkeni denir. \(n\) denemenin toplamı başarılı deneme sayısını verir; bu toplamı \(n\)'e bölersek gözlenen payı buluruz:
Sıfır ve birlerin aritmetik ortalaması, birlerin payıdır. Gerçek olasılık \(p\) ise tek bir \(Z_i\)'nin beklenen değeri \(1\cdot p+0\cdot(1-p)=p\) olur. Beklenen Değer ve Varyans yazısındaki ağırlıklı ortalama, tahminin neden doğru büyüklüğe yöneldiğini açıklar.
Denemeler aynı kuralla üretiliyor ve birbirinden bağımsızsa, her birinin beklenen değeri \(p\)'dir. Ortalamanın beklenen değeri de:
Aynı örnekleme düzenini tekrar tekrar uygulasak tahminlerin ortalaması gerçek olasılığa denk gelir. Buna yansızlık denir; tek bir denemenin tam isabet edeceğini söylemez. Çıkarımsal istatistikte gördüğümüz bu ayrım Monte Carlo için de geçerli.
Rastgele Noktalarla Bir Alanı Ölçelim
Zarda uygun sonuçları sayabiliyorduk. Şimdi [0,1] aralığından iki sayı seçip birim karenin içine bir nokta yerleştirelim. \(x\) ve \(y\) koordinatları birbirinden bağımsız ve 0 ile 1 arasında eşit yoğunlukta seçilsin. Karenin alanı \(1\cdot1=1\). İçindeki çeyrek birim çemberi belirleyen koşul \(x^2+y^2\leq1\), alanı ise \(\pi/4\)'tür.
Noktalar kare içinde eşit yoğunlukta seçildiği için bir noktanın çeyrek çemberin içine düşme olasılığı, alanların oranına eşittir:
\(n\) noktadan \(k\) tanesi içerideyse \(k/n\) alan oranı olan \(\pi/4\)'ü, \(4k/n\) da \(\pi\)'yi tahmin eder. Rastgele noktalarla bu sayısal tahmin arasındaki bağ, çember alanından gelir.
Sekiz olası nokta seçimi aşağıdaki gibi olsun. Ondalık virgül kullandığımız için koordinatları noktalı virgülle ayırdık. Son sütunda her noktanın \(x^2+y^2\leq1\) koşulunu sağlayıp sağlamadığı görülüyor:
| Nokta \((x,y)\) | \(x^2+y^2\) | İçeride mi? |
|---|---|---|
| \((0{,}1;\,0{,}2)\) | 0,05 | Evet |
| \((0{,}8;\,0{,}8)\) | 1,28 | Hayır |
| \((0{,}4;\,0{,}7)\) | 0,65 | Evet |
| \((0{,}9;\,0{,}5)\) | 1,06 | Hayır |
| \((0{,}3;\,0{,}9)\) | 0,90 | Evet |
| \((0{,}6;\,0{,}6)\) | 0,72 | Evet |
| \((0{,}2;\,0{,}4)\) | 0,20 | Evet |
| \((0{,}7;\,0{,}7)\) | 0,98 | Evet |
Altı nokta içeride; dolayısıyla \(\widehat\pi=4\cdot6/8=3\) buluyoruz. Gerçek \(\pi\) değerini sekiz noktayla tam bulmayı beklemeyiz. Bu liste bir bilgisayar çıktısı değil, hesabı elle izlemek için seçilmiş olası bir örneklem. Noktaları özellikle düzgün aralıklarla yerleştirseydik artık bağımsız rastgele örnekleme yapmış olmazdık.
Alan Saymaktan İntegral Ortalamasına
Alanı nokta saymak yerine yükseklikleri ortalayarak da tahmin edebiliriz. İntegral yazısında eğri altındaki alanı küçük katkılardan oluşturmuştuk. Burada rastgele seçilen konumlardaki yükseklikleri kullanacağız:
\(I\) aradığımız alan. İntegral kurallarıyla tam cevabı bulduk; örnekleme sonucunu onunla karşılaştıracağız. \(U\), 0 ile 1 arasında eşit yoğunlukta seçilen rastgele bir sayı olsun. Aralık uzunluğu 1 olduğundan \(U^2\)'nin beklenen değeri \(x^2\)'nin aralıktaki ortalamasına, yani \(I\)'ye eşittir:
Birbirinden bağımsız \(U_1,\ldots,U_n\) sayıları seçersek her sayının karesini alıp ortalarız. Bu kez sıfır veya bir değil, \(0\) ile \(1\) arasında değişebilen katkıları biriktiriyoruz:
Olası bir beşli seçim \(0{,}1,0{,}4,0{,}6,0{,}8,0{,}9\) olsun. Kareler sırasıyla \(0{,}01,0{,}16,0{,}36,0{,}64,0{,}81\)'dir:
Tam sonuç \(1/3\approx0{,}333\); beş noktayla bulduğumuz değer yaklaşık \(0{,}063\) uzaklıkta. Daha çok nokta genellikle tahmini kararlı kılar, fakat her yeni nokta bizi tam sonuca biraz daha yaklaştırmak zorunda değildir. Tahmin önce uzaklaşıp sonra yaklaşabilir.
Bu hesabı \(a\) ile \(b\) arasındaki herhangi bir \(f(x)\) fonksiyonuna taşıyabiliriz. \(U\)'yu bu aralıktan eşit yoğunlukta seçeriz. Örneklerden bulduğumuz ortalamayı da aralığın uzunluğu olan \(b-a\) ile çarparız:
Az önce \(a=0\) ve \(b=1\) olduğu için bu çarpan 1'di. Başka bir aralıkta çarpanı unutursak sonucun hem büyüklüğü hem birimi yanlış olur. Örneğin \(f(x)\) metre cinsinden bir yükseklikse örneklerin ortalaması da metredir; integralin metre kare cinsinden çıkması için aralığın uzunluğuyla çarpmamız gerekir. Fonksiyon negatif değer alıyorsa integral sıradan geometrik alanı değil, işaretli birikimi verir.
Ortak Fikir: Beklenen Değeri Yaklaşık Bulmak
Zarda olayın gerçekleşip gerçekleşmediğini kaydettik, çemberde noktanın yerini kontrol ettik, integralde \(U^2\) değerini hesapladık. Farklı işlemler gibi görünseler de her denemeye bir sayı verip sonunda bu sayıların ortalamasını aldık. Her denemenin verdiği sayıya \(Y\), aradığımız uzun dönem ortalamasına \(\mu=\mathbb E[Y]\) diyelim. Aynı dağılımdan bağımsız \(n\) sonuç, yani \(Y_1,\ldots,Y_n\), ürettiğimizde Monte Carlo tahminimiz şöyle olur:
Burada belirleyici nokta, beklenen değerin seçtiğimiz dağılıma göre hesaplanmasıdır. Zar adil değilse adil zarın olasılığını bulmuş olmayız. Noktalar karenin bir köşesine daha sık düşüyorsa içeride kalanların payını alan oranı olarak okuyamayız. Çok sayıda sonuç üretmek tek başına yetmez; örnekleri nasıl seçtiğimizi de bilmemiz gerekir.
Örnekler aynı koşullarda seçiliyorsa büyük sayıların yasası, örnek sayısı arttıkça \(\widehat\mu_n\)'nin hedef ortalamaya yaklaşacağını söyler. Yine de sınırlı sayıda örnekle bulduğumuz değer tam sonuç olmayabilir; hata da her yeni denemede düzenli biçimde azalmaz. Üstelik yaklaşılan değer, kullandığımız dağılımın ortalamasıdır. Dağılım gerçek durumu yanlış anlatıyorsa daha fazla deneme yapmak bu sorunu çözmez.
Tahminin Oynaklığını Nasıl Ölçeriz?
Bir denemenin sonucunun beklenen değer çevresinde ne kadar değiştiğini \(\sigma^2=\operatorname{Var}(Y)\) ile gösterelim. Bağımsız sonuçları topladığımızda varyansları da toplarız. Toplamı \(n\)'e bölerek ortalama aldığımızda ise varyans \(n^2\)'ye bölünür. Tahminin varyansı ve bunun karekökü olan standart hata böylece bulunur:
Standart sapma \(\sigma\), tek tek denemelerin sonuçlarının ne kadar değiştiğini gösterir. Standart hata ise deneyi baştan yapıp yeni örneklemler seçseydik bulacağımız ortalamaların ne kadar değişeceğini anlatır. Çıkarımsal İstatistik ve Hipotezler yazısında gördüğümüz ayrımı şimdi bu tahminin belirsizliğine uyguluyoruz. Örnek sayısını dört katına çıkarınca standart hata yarıya iner; onu on kat küçültmek için yaklaşık yüz kat örnek gerekir.
\(U^2\) integralinde bu hesabı sayılarla görebiliriz. \(U\) birim aralıktan eşit yoğunlukta seçildiği için \(\mathbb E[U^2]=1/3\). Varyansı bulmak için \(\mathbb E[U^4]=\int_0^1 x^4dx=1/5\) değerine de ihtiyacımız var. Şimdi bu iki değeri varyans formülüne yerleştirelim:
Buna göre \(n\) bağımsız noktayla yaptığımız integral tahmininin teorik standart hatası \(\sqrt{4/(45n)}\)'dir. \(n=100\) için yaklaşık \(0{,}0298\), \(n=10\,000\) için yaklaşık \(0{,}00298\) çıkar. Nokta sayısını yüz katına çıkardık, tipik dalgalanma ise yalnızca onda birine indi. Bunlar tek bir denemenin hatasına konmuş sınırlar değildir; deneyi tekrar tekrar yapsak tahminlerin ne kadar değişebileceğini gösterir.
Gerçek bir problemde \(\sigma\)'yı genellikle baştan bilmeyiz. Bunun yerine gözlediğimiz sonuçlardan örneklem standart sapması \(s\)'yi hesaplar, standart hatayı yaklaşık \(s/\sqrt n\) alırız. \(n=1\)'de bunu yapamayız; tek gözlem bize sonuçların yayılımını göstermez.
Örneklem yeterince büyükse, sonuçlar bağımsız biçimde aynı dağılımdan geliyorsa ve varyansları sonluysa merkezî limit teoremi ortalamanın yaklaşık Normal davranmasını sağlar. Bu koşullarda \(\widehat\mu_n\pm1{,}96\,s/\sqrt n\) sık kullanılan yaklaşık yüzde 95 güven aralığıdır. Buradaki “yüzde 95”, elimizdeki tek aralığın hedefi içerme olasılığı değildir. Aynı yöntemle tekrar tekrar aralık kursaydık bunların yaklaşık yüzde 95'i hedefi kapsardı. Örneklem çok küçükse, dağılım çok çarpıksa veya olay çok seyrek görülüyorsa bu Normal yaklaşım iyi çalışmayabilir.
Nadir Olaylar Neden Daha Zordur?
Bir olayın gerçek olasılığı \(p\) olsun. Olay gerçekleştiğinde 1, gerçekleşmediğinde 0 yazan göstergeye \(Z\) dersek bu gösterge Bernoulli dağılımı izler; varyansı \(p(1-p)\)'dir. \(n\) bağımsız denemede olayın görülme payı için standart hata böylece:
Gerçek \(p\) değerini bilmiyorsak formülde gözlediğimiz \(\widehat p\) değerini kullanabiliriz. Fakat olay çok nadirse hiç gerçekleştiğini görmeyebiliriz. Bu durumda hesaplanan standart hata da sıfır çıkar. Olayın imkânsız olduğunu bundan çıkaramayız.
Gerçek olasılığın \(p=0{,}001\) olduğunu düşünelim. Bin bağımsız deneme yapıp olayı bir kez bile görmeme olasılığımız:
Yani yaklaşık yüzde 36,8 olasılıkla elimizde hiç olay görülmemiş bir örneklem kalır, oysa olayın gerçek olasılığı sıfır değildir. Seyrek arızaları, büyük kayıpları veya sıra dışı model hatalarını düz rastgele örneklemeyle görmek için çok sayıda deneme gerekebilir. Böyle bir örneklemden hesaplanan basit Normal güven aralığına da temkinli yaklaşmalıyız.
Daha Çok Örnek Dışında Ne Yapabiliriz?
Deneme sayısını artırmadan da örneklerin nasıl dağıldığını değiştirebiliriz. Bunun basit bir yolu, incelediğimiz aralığı parçalara ayırmaktır. \(\int_0^1x^2dx\) örneğinde \([0,0{,}5]\) ve \([0{,}5,1]\) aralıklarının her birinden birer rastgele sayı seçelim. İki aralığın uzunluğu da \(0{,}5\) olduğundan sonuçlarına eşit ağırlık veririz. Bu yönteme tabakalı örnekleme (stratified sampling) denir.
İlk yarıdan \(0{,}2\), ikinci yarıdan \(0{,}8\) seçtiğimizi düşünelim. Bu denemenin sonucu:
Burada sonucun \(1/3\)'e yakın olması, tabakalı örneklemenin her denemede daha iyi sonuç vereceğini göstermez. Asıl olası kazanç, örnekleri farklı bölgelere yayarak tekrarlanan tahminlerin değişkenliğini azaltmaktır. Aralıkların uzunlukları farklı olsaydı sonuçları yarı yarıya ortalamak doğru olmazdı; her bölgenin ortalamasını kendi uzunluğuyla ağırlıklandırmamız gerekirdi. Yoksa hesapladığımız integralin hedefini değiştiririz.
Çok nadir olaylar için olayın görüldüğü bölgeden daha sık örnek seçebilir, sonra her sonucu seçilme olasılığındaki değişime göre düzeltebiliriz. Buna önem örneklemesi (importance sampling) denir. Nadir bölgeye daha sık bakıp düzeltmeyi yapmazsak olayın gerçek olasılığını olduğundan büyük buluruz. Kısacası örnekleme kuralını değiştirdiğimizde ortalamayı hesaplama biçimimizi de buna uydurmalıyız.
Yapay Zekâ Modelinin Ortalama Maliyetine Bağlantı
Çapraz Entropi yazısında tek bir tahminin kaybını ölçmeyi, Optimizasyon ve Maliyet Fonksiyonları yazısında bu kayıpları ortak bir hedefte toplamayı görmüştük. Gradyan inişinde o hedefi azaltmaya çalıştık. Şimdi eğitim kayıtlarının maliyetlerini \(\ell_1,\ldots,\ell_m\) ile gösterelim; toplam \(m\) kayıt var. Veri kümesinin tam ortalama maliyeti:
Kayıtlardan birini rastgele seçelim. \(1\) ile \(m\) arasındaki seçilen kayıt numarasına \(K\) dersek bu kaydın maliyeti \(\ell_K\) olur. Her kayıt \(1/m\) olasılıkla seçildiğinden bu maliyetin beklenen değeri:
Tek bir rastgele kaydın maliyeti bile, ortalama olarak, bu sabit veri kümesinin tam maliyetini hedefliyor. Birkaç kayıt seçersek onların ortalamasını da yaklaşık hesap olarak kullanabiliriz. Grubun büyüklüğüne \(b\), seçilen kayıt numaralarına \(K_1,\ldots,K_b\) diyelim. Seçimleri bağımsız ve yerine koyarak yaptığımız basit düzende:
Bu küçük grubun ortalaması kimi zaman tam maliyetin üstüne, kimi zaman altına düşer. Her kaydın parametreye göre türevini alabiliyorsak seçilen türevlerin ortalaması da tam veri gradyanını tahmin eder. Önceki yazıdaki güncellemeyi bu yaklaşık gradyanla yaptığımızda adımların yönü ve büyüklüğü dalgalanabilir. Rastgele kayıt seçmenin yararı, her adımda bütün veri kümesini hesaplamak zorunda kalmamamızdır. Hangi kayıtların seçileceği ile adım büyüklüğü yine ayrı kararlardır.
Modelin farklı girdiler ve sonuçlar karşısındaki beklenen kaybını da bu yolla inceleyebiliriz. Önce hangi durumun ne sıklıkta görüleceğini anlatan bir dağılım kurar, sonra bu dağılımdan örnekler seçip kayıplarının ortalamasını alırız. Bulduğumuz değer varsaydığımız dağılım altındaki beklenen kayıptır. Dağılım gerçek kullanımı yansıtmıyorsa Monte Carlo hesabını çok hassas yapsak bile yanlış soruyu yanıtlamış oluruz.
Bir Simülasyonun Koşulları ve Sınırları
Bir simülasyonun sonucunda iki farklı hata kaynağı olabilir. Rastlantısal hata, aynı kuralla başka örnekler seçseydik sonucun değişecek olmasıdır; standart hata bu değişimi ölçer. Sistematik hata ise yanlış dağılımdan seçim yapmak, bazı durumları hiç hesaba katmamak, sonucu yanlış ölçmek veya ağırlıkları unutmak yüzünden hedefin kaymasıdır. \(n\)'yi büyütmek sistematik hatayı gidermez.
Standart \(\sigma/\sqrt n\) hesabı, katkılar bağımsızsa, aynı dağılımdan geliyorsa ve varyansları sonluysa geçerlidir. Birbirine bağlı sonuçları bağımsız denemeler gibi saymak belirsizliği olduğundan küçük gösterebilir. Sonlu bir veri kümesinden kayıtları yerine koymadan seçtiğimizde de aynı formülü olduğu gibi kullanamayız; gerekli düzeltme seçim biçimine bağlıdır. Katkıların varyansı çok büyükse veya sonlu değilse yakınsama ve güven aralığı ayrıca incelenmelidir.
Bilgisayardaki sözde rastgele sayılar çoğunlukla bir başlangıç değerinden üretilir. Aynı başlangıç değerini aynı programla kullandığımızda genellikle aynı örnek dizisini yeniden elde ederiz; böylece hesabı denetleyebiliriz. Fakat dizinin tekrar edilebilir olması örnekleme belirsizliğini ortadan kaldırmaz. Bir çalışmayı yeniden yapabilmek için başlangıç değerini, kullanılan dağılımı, örnek sayısını ve hesaplanan ölçüyü birlikte kaydetmeliyiz.
Her soruda Monte Carlo kullanmamız gerekmez. \(\int_0^1x^2dx\) gibi basit bir integrali doğrudan ve tam olarak hesaplayabiliriz. Tek boyutlu düzgün fonksiyonlarda düzenli noktalı sayısal integral yöntemleri de çoğu kez aynı hesap bütçesiyle daha kesin sonuç verir. Doğrudan hesabın zor olduğu dağılımlar, karmaşık bölgeler ve çok boyutlu ortalamalar ise Monte Carlo'nun işe yaradığı yerlerdir. Örnek sayısına bağlı \(1/\sqrt n\) belirsizlik ölçeği boyut sayısından doğrudan etkilenmez; yine de her örneği üretmenin maliyeti ve katkıların varyansı boyut arttıkça değişebilir.
Monte Carlo'da Sık Yapılan Hatalar
- Tahmini tam değer sanmak: Tek bir çalışmadaki \(\widehat p\) veya \(\widehat I\), örnekleme nedeniyle değişir; yanında örnek sayısı ve uygun bir belirsizlik ölçüsü gerekir.
- Yanlış dağılımdan örnek seçmek: Alan oranı hesabında noktalar kare içinde eşit yoğunlukta olmalıdır. Seçim mekanizması değişirse ağırlıklar da değişmelidir.
- Bağımlı denemeleri bağımsız saymak: Aynı senaryonun küçük değişikliklerini bin ayrı deneme gibi görmek standart hatayı gereğinden küçük gösterebilir.
- Sıfır gözlemden sıfır olasılık çıkarmak: Nadir olay, sınırlı sayıda denemede hiç görünmeyebilir.
- Çok örneğin her yanlılığı gidereceğini düşünmek: Yanlış modelin sonucu çok sayıda denemeyle yalnızca daha kararlı hale gelir.
- Ortalamanın birimini unutmak: İntegralde aralık uzunluğu çarpanı ve varsa olay kaybının gerçek birimi korunmalıdır.
- Rastgele örnekleme ile düzenli nokta dizisini aynı yöntem saymak: İkisi de yaklaşık hesap sağlayabilir; fakat bağımsız örnekler için kurulan standart hata formülü düzenli noktalar için doğrudan kullanılmaz.
Bir Monte Carlo Sonucunu Nasıl Okumalıyız?
- Hedefi yazın. Bir olayın olasılığını mı, dağılımın beklenen değerini mi, yoksa bir integrali mi tahmin ediyorsunuz?
- Örnekleme kuralını belirleyin. Hangi dağılımdan, hangi aralıkta, bağımsız mı ve yerine koyarak mı seçim yapılıyor?
- Her örneğin katkısını tanımlayın. Sıfır-bir göstergesi, fonksiyon değeri veya ağırlıklı bir sonuç olabilir.
- Ortalamanın hangi hedefe eşit olacağını doğrulayın. Alan hesabındaki eşit yoğunluk veya integraldeki aralık uzunluğu gibi çarpanları kontrol edin.
- Rastlantısal belirsizliği hesaplayın. Örnek sayısını, standart hatayı ve nadir olaylar gibi yaklaşımın zayıf kaldığı durumları birlikte değerlendirin.
- Model varsayımlarını ayrıca sınayın. Doğru hesaplanmış bir ortalama, gerçek dünyayı temsil etmeyen bir dağılımı düzeltmez.
Sonuç: Rastgele Denemelerden Ölçülü Bir Yaklaşıma
Monte Carlo'da yaptığımız temel iş, zor bir toplamı veya integrali uygun bir rastgele değişkenin beklenen değeri olarak ifade edip onu örnek ortalamasıyla tahmin etmektir. Zar denemelerinde olayları saydık, kareye attığımız noktalarla alan oranını bulduk, rastgele seçtiğimiz yüksekliklerle integrali yaklaştırdık. Yapay zekâ örneğinde ise seçilen kayıtların ortalama kaybını bütün eğitim verisinin maliyetini tahmin etmek için kullandık.
Her yeni örneklem biraz farklı sonuç verebilir. Bağımsız ve uygun dağılımdan gelen katkılarda standart hata yaklaşık \(1/\sqrt n\) hızında küçülür; nadir olayları görmek içinse çok daha fazla deneme gerekebilir. Örnekleme kuralındaki sistematik bir hata, deneme sayısını artırınca kaybolmaz. Bu yüzden bir Monte Carlo sonucunu okurken tahmin edilen değerin yanında hedefe, örneklerin nasıl seçildiğine ve belirsizliğe de bakmalıyız.
Burada olasılık, ortalama, integral ve optimizasyon fikirlerini aynı hesapta buluşturduk ve yapay zeka çalışmalarımız için gerekli matematiksel temelimizi kurmuş olduk. Yapay zeka külliyatına giden yolda bundan sonrasında bize bir programlama dili gerekli olacak. Sıradaki Programlama Nedir? Python ile İlk Adım yazısında matematik bölümünü kapatıp, Python bölümüne başlayacağız ve tümevarım yöntemiyle ilerlediğimiz külliyatımızda sağlam adımlarla yolumuza devam edeceğiz.
Yazar: Levent KARAGÖL