Gündelik bir tablo gibi, matris de sayıları satır ve sütunlar halinde düzenler. Böylece verileri bir arada gösterebilir; bir vektörü ölçeklendirme, döndürme ya da yeni özelliklere dönüştürme işlemlerini tek bir kuralla ifade edebiliriz. Yapay zekâda görüntüler ve eğitim verileri kadar sinir ağı ağırlıkları ve dikkat hesapları da matrislerle gösterilir. Bu makalede matrisleri bir tablodan yola çıkarak tanıyacak, temel işlemleri adım adım öğrenecek ve bir yapay zekâ katmanında ne yaptıklarını somut bir örnekle göreceğiz.
Bir Tablodan Matris Fikrine
Üç arkadaşın bir hafta sonu boyunca kaç bardak çay ve kahve içtiğini not ettiğimizi düşünelim. Sonuçları aşağıdaki gibi küçük bir tabloda gösterebiliriz:
| Kişi | Çay | Kahve |
|---|---|---|
| Ayşe | 3 | 1 |
| Mehmet | 2 | 2 |
| Zeynep | 4 | 0 |
Kişi adlarını ve içecek başlıklarını bir kenara bırakıp yalnızca sayılara bakarsak şu düzenli yapı kalır:
Sayılardan oluşan bu dikdörtgen tabloya matris (matrix) denir. Yatay dizilere satır, dikey dizilere ise sütun adı verilir. Bu örnekte her satır bir kişiyi, her sütun bir içecek türünü temsil ediyor. Sayıların ne anlama geldiğini ise tablonun bağlamından biliyoruz.
Bir matrisi veri tablosu olarak kullanabiliriz. Birazdan göreceğimiz gibi matris, bir vektörü başka bir vektöre dönüştüren kuralı da gösterebilir. Nasıl yorumlayacağımız, onu hangi amaçla kullandığımıza bağlıdır.
Vektörden Matrise Geçiş
Vektörler makalesinde bir kişinin boyu, kilosu ve yaşı gibi birbiriyle ilişkili sayıları tek bir listede tutabileceğimizi görmüştük. Örneğin bir kişiyi üç özellikle şöyle gösterebiliriz:
Burada sırasıyla boy, kilo ve yaş değerleri bulunuyor. Peki yüz kişi varsa ne yapacağız? Yüz ayrı vektör yazmak yerine onları bir matrisin satırlarında bir araya getirebiliriz. Böylece her satır bir kişiyi, her sütun bir özelliği gösterir:
Bu küçük örnekte üç kişi ve üç özellik vardır. Gerçek bir veri kümesinde binlerce satır ve yüzlerce sütun bulunabilir. Yapay zekâda birden fazla örneğin birlikte işlendiği böyle bir topluluğa çoğu zaman veri grubu ya da İngilizce adıyla batch denir.
Matrisin Boyutu Nasıl Okunur?
Bir matrisin kaç satır ve kaç sütundan oluştuğuna matrisin boyutu denir. Boyut her zaman “satır sayısı çarpı sütun sayısı” sırasıyla okunur. Az önceki \(\mathbf{X}\) matrisi üç satır ve üç sütundan oluştuğu için \(3\times3\) boyutundadır.
Daha genel olarak \(\mathbf{A}\) matrisinin \(m\) satırı ve \(n\) sütunu varsa:
ifadesini kullanırız ve “\(\mathbf{A}\), \(m\) çarpı \(n\) boyutunda bir matristir” deriz. Buradaki \(a_{ij}\) gösterimi, \(i\). satır ile \(j\). sütunun kesişimindeki sayıyı anlatır. Önce satır, sonra sütun söylenir.
Örneğin:
matrisi \(2\times3\) boyutundadır. İkinci satırın üçüncü sütunundaki eleman \(7\) olduğu için \(b_{23}=7\) yazarız. “23” burada yirmi üç sayısı değildir; “ikinci satır, üçüncü sütun” adresidir.
İki matrisin eşit sayılabilmesi için önce boyutlarının aynı olması, ardından karşılıklı bütün elemanlarının eşit olması gerekir. Sayılar aynı olsa bile satır ve sütunlardaki yerleri değişmişse matrisler eşit değildir. Çünkü bir elemanın taşıdığı anlam, çoğu zaman bulunduğu satır ve sütuna bağlıdır.
Matrislerde Toplama ve Sayıyla Çarpma
İki veri tablosunu toplayabilmek için karşılıklı hücrelerin aynı şeyi anlatması gerekir. Matrislerde de aynı düşünce geçerlidir: Yalnızca boyutları aynı olan matrisler toplanabilir. Karşılıklı elemanları tek tek toplarız.
Bir matrisi tek bir sayıyla çarptığımızda ise her elemanı o sayıyla çarparız. Bu tek sayıya skaler denir:
Aynı işlemleri büyük veri kümelerine de uygulayabiliriz. İki farklı ölçüm gününün sonuçlarını toplamak matris toplamına, bütün fiyatları yüzde 10 artırmak ise bir matrisi \(1{,}10\) ile çarpmaya benzer.
Matris ile Vektörü Çarpmak
Bir matris, bir vektörü başka bir vektöre dönüştürebilir. Küçük bir örnekle başlayalım:
Matrisin birinci satırı giriş vektörüyle çarpılıp toplanınca çıktının birinci sayısı oluştu. İkinci satır da aynı işi yaparak çıktının ikinci sayısını üretti. Başka bir ifadeyle her çıktı, girişteki sayıların farklı ağırlıklarla bir araya getirilmiş halidir.
Yapay zekâ modelleri giriş özelliklerini farklı ağırlıklarla birleştirerek yeni özellikler üretebilir. Matrisin her satırı, “Girişteki sayılara hangi ağırlıkları vereceğim?” sorusuna ayrı bir cevap verir.
Boyutlar Neden Uyuşmak Zorunda?
Bir \(2\times3\) matrisi, üç elemanlı bir vektörle çarpalım:
Matrisin her satırında üç sayı bulunduğu için giriş vektöründe de üç sayı bulunmalıdır. Üç giriş sayısı, matrisin iki satırı tarafından işlenmiş ve iki çıkış sayısına dönüşmüştür. Bu nedenle genel biçim şöyledir:
İçerideki \(n\) sayıları eşleşir; dışarıda kalan \(m\times1\), sonucun boyutunu verir. Bunu ezberlemek yerine anlamını düşünelim: Dönüşüm \(n\) giriş bekliyor ve \(m\) çıkış üretiyor.
Birim Matris: Hiçbir Şeyi Değiştirmeyen Dönüşüm
Bir sayıyı \(1\) ile çarptığımızda sayı değişmez. Matrislerde aynı görevi birim matris (identity matrix) üstlenir. İki boyutlu bir vektör için birim matris şöyledir:
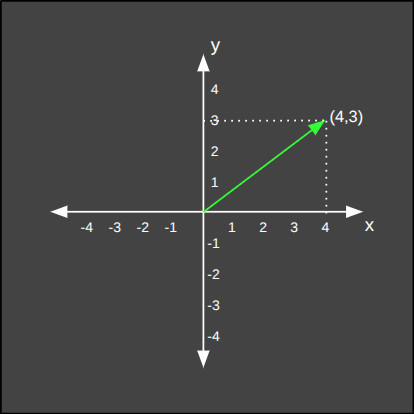
Örneğin \(\mathbf{v}=[4\ \ 3]^{T}\) sütun vektörünü birim matrisle çarpalım. Buradaki üstteki \(T\), yatay yazılan listenin sütun vektörü olarak düşünüldüğünü belirtir:
Vektör aynı yönde ve aynı uzunlukta kaldı. Birim matris ileride ters matrisi tanımlarken de işimize yarayacak; çünkü bir matris ile tersini peş peşe uyguladığımızda geriye birim dönüşüm kalır.
Ölçeklendirme: Vektörü Büyütmek ve Küçültmek
Bir şekli büyütmek, bir fotoğrafı yatay yönde genişletmek veya bir vektörün bileşenlerini farklı oranlarda değiştirmek için ölçeklendirme matrisi kullanabiliriz.
Her İki Yönde İki Kat Büyütme

Köşegendeki iki sayısı, hem yatay hem dikey bileşeni iki katına çıkardı. Vektörün yönü değişmedi; uzunluğu iki katına çıktı.
Her İki Yönde Yarıya Küçültme
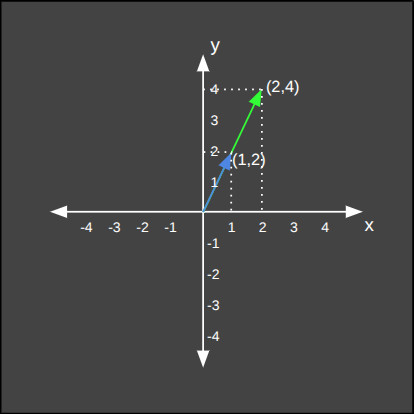
Bu kez köşegendeki \(0{,}5\) değerleri iki bileşeni de yarıya indirdi. İlk işlemin tersini yapmış olduk.
Yatay ve Dikey Yönleri Farklı Ölçeklendirme
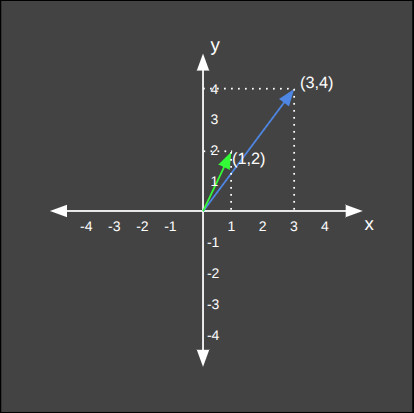
Yatay bileşen üçle, dikey bileşen ikiyle çarpıldığı için vektörün hem uzunluğu hem yönü değişti. Eksenleri farklı oranlarda ölçeklediğimizde böyle bir sonuç elde edebiliriz.
Döndürme Matrisi: Yönü Değiştirmek
Bir noktayı ya da vektörü başlangıç noktası etrafında saat yönünün tersine \(\theta\) açısı kadar döndürmek için şu matrisi kullanırız:
Buradaki sinüs ve kosinüs değerleri, dönen vektörün yatay ve dikey eksenlere düşen paylarını hesaplar. Sayılarla uygulayalım.
Altmış Derece Döndürme
\(\cos(60^\circ)=0{,}5\) ve \(\sin(60^\circ)\approx0{,}866\) değerlerini kullanalım:
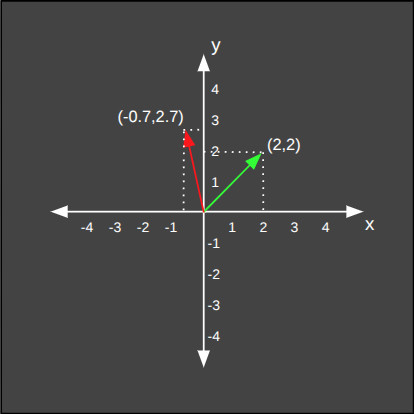
İlk bileşen \(0{,}5\cdot2-0{,}866\cdot2\), ikinci bileşen ise \(0{,}866\cdot2+0{,}5\cdot2\) hesabından geldi. Yön değişti; fakat döndürme vektörün uzunluğunu değiştirmedi.
Doksan Derece Döndürme
Doksan derece için \(\cos(90^\circ)=0\) ve \(\sin(90^\circ)=1\) olur. Böylece dönüşüm matrisi oldukça sadeleşir:
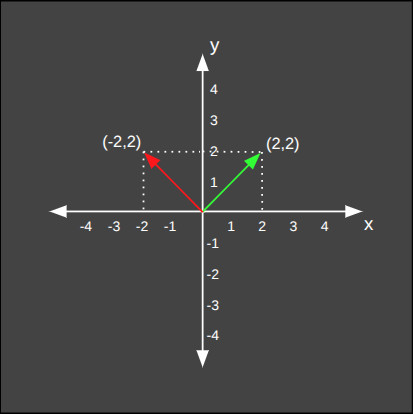
Döndürme matrisleri bilgisayar grafiklerinde, robot kollarında, harita uygulamalarında ve görüntü işlemede sık kullanılır. Yapay zekâda da veriyi farklı yönlerde inceleyen ya da görüntüler üzerinde dönüşüm yapan işlemlerin temelinde benzer hesaplar bulunur.
Matris Çarpımı: İki İşlemi Birleştirmek
Matris çarpımı, karşılıklı hücreleri çarpmaktan ibaret değildir. Her sonuç hücresi, soldaki matrisin bir satırı ile sağdaki matrisin bir sütununun eşleştirilip toplanmasıyla oluşur.
\(\mathbf{A}\), \(2\times3\); \(\mathbf{B}\) ise \(3\times2\) boyutundadır. Ortadaki iki boyut, yani \(3\) ve \(3\), eşleştiği için çarpım yapılabilir. Sonucun boyutu dışarıda kalan \(2\times2\) olur:
Matris çarpımı dönüşümleri de birleştirir. Bir matris bir dönüşümü, diğeri ikinci bir dönüşümü temsil ediyorsa çarpımları ikisini tek bir dönüşüm olarak ifade eder.
Dönüşüm Sırası Neden Önemlidir?
Önce \(\mathbf{A}\), sonra \(\mathbf{B}\) dönüşümünü uyguladığımızı düşünelim. Sütun vektörü kullanırken işlem şöyle yazılır:
Yani önce uygulanan matris vektöre daha yakın, sağ tarafta bulunur. Yazıyı sağdan sola okuruz: Önce \(\mathbf{A}\), sonra \(\mathbf{B}\). Bu sıra çoğu durumda değiştirilemez; genel olarak \(\mathbf{A}\mathbf{B}\neq\mathbf{B}\mathbf{A}\) olur.
Bunu iki basit dönüşümle görelim. \(\mathbf{S}\) yatay yönü iki katına çıkarsın, \(\mathbf{R}\) ise vektörü doksan derece döndürsün:
Önce ölçeklendirip sonra döndürürsek:
Önce döndürüp sonra ölçeklendirirsek:
Aynı iki işlem, farklı sırayla uygulanınca farklı sonuç verdi. Günlük hayatta da benzerini görürüz: Bir kâğıdı önce katlayıp sonra kesmek ile önce kesip sonra katlamak aynı sonucu vermeyebilir.
Ölçeklendirme ve Döndürmeyi Birleştirelim
Şimdi \([1\ \ 2]^T\) vektörünü önce her yönde iki kat büyütüp ardından doksan derece döndürelim:
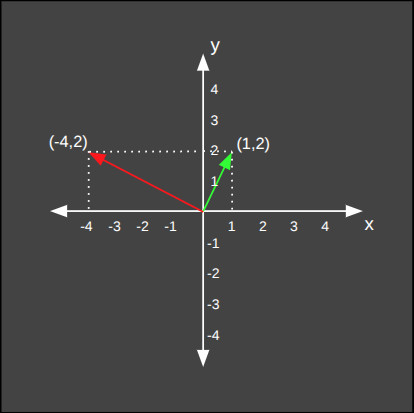
İki matrisi önceden birleştirirsek:
Artık aynı birleşik matrisi çok sayıda vektöre uygulayabiliriz. Burada ölçek her yönde aynı olduğu için ölçeklendirme ile döndürmenin sırası sonucu değiştirmez. Ancak az önce yatay yönü farklı ölçeklediğimiz örnekte sıranın sonucu değiştirdiğini gördük. Özel bir örnekte sıranın önemsiz çıkması, genel kuralın da böyle olduğu anlamına gelmez.
Birleştirmek Her Zaman Ne Kadar Kazandırır?
İki ayrı \(2\times2\) matrisi her vektöre peş peşe uygulamak, vektör başına toplam sekiz sayı çarpımı gerektirir. Matrisleri bir kez önceden birleştirirsek, birleşik matrisi oluşturmak için bir defalık sekiz çarpım yapar; sonra her vektör için dört çarpımla yetiniriz. \(N\) vektör için çarpım sayısı kabaca \(8N\) yerine \(8+4N\) olur.
Çarpım sayısındaki bu tasarruf çok sayıda vektörde işe yarayabilir. Gerçek çalışma süresi ise donanıma, belleğe, matris boyutuna ve kullanılan yazılıma da bağlıdır. Ne kadar hızlandığımızı ölçerek öğrenebiliriz.
Transpoz: Satırlarla Sütunların Yerini Değiştirmek
Bir matrisin satırlarını sütun, sütunlarını satır yaptığımızda transpozunu (transpose) elde ederiz. \(\mathbf{A}\) matrisinin transpozu \(\mathbf{A}^{T}\) ile gösterilir ve “A transpoz” diye okunur:
\(\mathbf{A}\), \(2\times3\) boyutundayken \(\mathbf{A}^{T}\), \(3\times2\) boyutuna geçti. İçindeki sayılar değişmedi; yalnızca adresleri değişti. Transpoz, satır olarak saklanan veri örneklerini sütun düzenine çevirmede ve iki vektörün nokta çarpımını matris gösterimiyle yazmada sık karşımıza çıkar.
Determinant: Dönüşüm Alanı Ne Kadar Değiştiriyor?
Kare bir matrisin, yani satır ve sütun sayısı eşit bir matrisin, önemli özetlerinden biri determinanttır. \(2\times2\) bir matris için hesap şöyledir:
Sayılarla görelim:
İki boyutlu bir dönüşümde determinantın geometrik anlamı, alanın nasıl değiştiğidir. \(|\det(\mathbf{A})|=10\) ise birim kare dönüşümden sonra on kat alana sahip bir paralelkenara dönüşür. Determinantın negatif olması ayrıca yönün ters döndüğünü, örneğin bir aynalama gerçekleştiğini gösterir.
Determinant sıfırsa iki boyutlu bir alan bir doğruya ya da tek bir noktaya sıkışabilir. Farklı girdiler aynı çıktıya gittiği için bilgi kaybolur; her çıktıyı benzersiz bir girdiye geri çeviremeyiz.
İki farklı vektör aynı sonuca dönüştü. Yalnızca \([2\ \ 4]^T\) çıktısına bakarak başlangıçta hangisinin kullanıldığını bilemeyiz. “Determinant sıfırsa bilgi kaybı olur” sözünün somut anlamı budur.
Ters Matris: Dönüşümü Geri Almak
Bir dönüşümü uyguladıktan sonra başlangıçtaki vektöre geri dönmek isteyebiliriz. Bunu yapan matrise ters matris (inverse matrix) denir ve \(\mathbf{A}^{-1}\) ile gösterilir:
Bu ifade, önce \(\mathbf{A}\), sonra \(\mathbf{A}^{-1}\) uygulandığında hiçbir şeyi değiştirmeyen birim matrise ulaştığımızı söyler. \(2\times2\) bir matris için, determinant sıfır değilse ters matris şöyle hesaplanır:
Az önce determinantını \(10\) bulduğumuz matrise uygulayalım:
Kontrol etmek için iki matrisi çarpalım:
Döndürme işlemlerinde ters matrisin anlamı özellikle kolay görülür. Bir vektörü doksan derece saat yönünün tersine döndürdüysek, ters dönüşüm onu doksan derece saat yönünde döndürür:
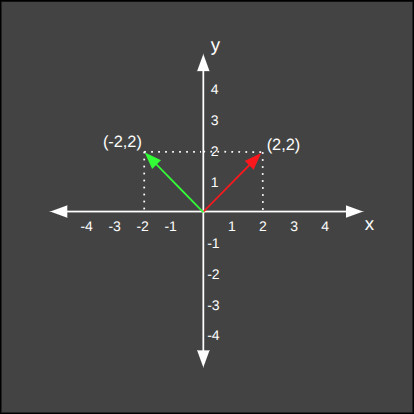
Her matrisin tersi yoktur. Standart anlamdaki ters matris yalnızca kare ve geri çevrilebilir matrisler için vardır. Determinant sıfırsa formülde sıfıra bölme oluşur. Farklı girdilerin aynı çıktıya dönüşmesi de başlangıçtaki vektörü bulmamızı engeller.
Denklem Sistemlerini Matrisle Çözmek
Matrislerin klasik kullanım alanlarından biri, birden fazla bilinmeyenin birlikte bulunduğu denklemleri çözmektir. Şu iki denklemi düşünelim:
Bilinmeyenlerin önündeki sayıları bir matriste, bilinmeyenleri ve sonuçları da ayrı vektörlerde toplayabiliriz:
Böylece iki denklem tek bir kısa ifadeye dönüşür: \(\mathbf{A}\mathbf{x}=\mathbf{b}\). Eğer \(\mathbf{A}\) matrisinin tersi varsa iki tarafı soldan \(\mathbf{A}^{-1}\) ile çarparız:
Bu örnekte ters matris:
olduğu için:
Sonuç \(x=3\) ve \(y=1\) olur. Yerlerine yazarsak \(2\cdot3+1=7\) ve \(3-1=2\) eşitliklerinin ikisi de sağlanır. Küçük bir sistemi elle de çözebiliriz; matris gösterimi aynı yöntemi çok daha büyük sistemlerde düzenli biçimde kullanmamızı sağlar.
Matris ile Yapılamayan Bir Şey: Sadece Ötelemek
İki boyutlu bir matrisi bir vektörle çarparak döndürme, ölçeklendirme, aynalama veya eğme yapabiliriz. Fakat aynı boyuttaki sıradan bir matris çarpımı, bütün noktaları tek başına sağa üç birim taşıyamaz. Çünkü matris çarpımıyla yapılan her doğrusal dönüşüm sıfır vektörünü yine sıfıra gönderir:
Bir vektörü ötelemek için dönüşümden sonra ayrı bir vektör ekleriz:
Buradaki \(\mathbf{b}\), bütün sonuçlara eklenecek kaydırma vektörüdür. \(\mathbf{A}\mathbf{x}\) kısmına doğrusal dönüşüm, buna \(\mathbf{b}\) eklenmiş haline ise afin dönüşüm denir. Yapay sinir ağlarında göreceğimiz “bias” tam olarak böyle bir kaydırma görevi görür.
Aynı Yerde Görünen İki Farklı Çarpım
Matrislerle çalışırken iki işlem sık karıştırılır:
- Eleman eleman çarpım: Karşılıklı hücreler çarpılır. Temel tanımda bunun için matrislerin boyutları aynı olmalıdır. Bu işleme Hadamard çarpımı da denir ve çoğu zaman \(\odot\) işaretiyle gösterilir.
- Matris çarpımı: Satırlar sütunlarla eşleştirilir. Burada iç boyutların uyuşması gerekir ve işlem dönüşümleri birleştirir.
İki sonuç aynı değildir. Bir yazılımda çarpma işareti gördüğümüzde hangi işlemin kastedildiğini kontrol etmeliyiz; farklı araçlar farklı simgeler kullanabilir.
Yapay Zekâda Matrisler Nerede Karşımıza Çıkar?
Yapay zekâda matrisler verileri düzenler, görüntüleri sayısal olarak gösterir ve model hesaplarında kullanılır. Bu görevleri ayrı ayrı inceleyelim.
1. Veri Kümeleri
Bir ev fiyatı modelinde her satır bir evi; sütunlar metrekare, oda sayısı, bina yaşı ve merkeze uzaklık gibi özellikleri gösterebilir. Bin ev ve dört özellik varsa veri matrisi \(1000\times4\) boyutundadır. Model böylece tek bir evi değil, çok sayıda örneği düzenli bir yapı içinde işleyebilir.
2. Görüntüler
Siyah-beyaz bir görüntü, her hücresinde bir pikselin parlaklığını taşıyan matris gibi düşünülebilir. \(28\times28\) piksellik bir görüntü, 784 sayı içerir. Renkli görüntülerde kırmızı, yeşil ve mavi kanallar için birden fazla böyle sayı tablosu bulunur. Görüntü tanıma modelleri bu sayıların içindeki kenar, doku ve biçim örüntülerini öğrenmeye çalışır.
3. Kelime ve Kavram Gösterimleri
Bir dil modelinde kelimeler ya da kelime parçaları vektörlerle temsil edilebilir. Binlerce farklı parçanın vektörlerini alt alta koyduğumuzda büyük bir gömme matrisi (embedding matrix) oluşur. Bir kelime parçası modele geldiğinde, ona karşılık gelen satır seçilir ve sonraki hesaplarda kullanılır.
4. Sinir Ağı Ağırlıkları
Bir yapay sinir ağı katmanı, girişteki özellikleri yeni özelliklere dönüştürür. Her bağlantının etkisini ayrı ayrı yazmak yerine bu ağırlıkları bir matriste toplarız. Katmanın doğrusal bölümündeki temel hesap:
şeklindedir. Burada \(\mathbf{x}\) giriş vektörü, \(\mathbf{W}\) ağırlık matrisi, \(\mathbf{b}\) kaydırma vektörü ve \(\mathbf{y}\) katmanın çıktısıdır.
Küçük Bir Yapay Sinir Ağı Katmanı Hesabı
Girişimiz iki sayıdan oluşsun:
Önce ağırlık matrisi ile giriş vektörünü çarpalım, sonra kaydırmayı ekleyelim:
Birinci çıktı, girişteki \(2\) ve \(3\) sayılarına sırasıyla \(0{,}5\) ve \(1\) ağırlıkları verilerek, ardından \(1\) eklenerek üretildi. İkinci çıktı aynı girişleri bu kez \(-1\) ve \(2\) ağırlıklarıyla birleştirdi. Tek bir matris çarpımı, iki farklı ağırlıklı toplamı aynı anda hesapladı.
Model eğitilirken \(\mathbf{W}\) ve \(\mathbf{b}\) içindeki sayılar, tahmin hatasını azaltacak biçimde küçük adımlarla değiştirilir. Modelin öğrendikleri çoğu zaman bu sayılara yansır. Bu değişimin nasıl hesaplandığını türev, gradyan ve geri yayılım konularında ayrıntılı olarak göreceğiz.
5. Dikkat (Attention) Hesapları
Büyük dil modellerinde bir kelimenin diğer kelimelerle ne kadar ilişkili olduğunu hesaplayan dikkat (Attention) mekanizması da matris çarpımı kullanır. Sorgu ve anahtar adı verilen sayı tabloları \(\mathbf{Q}\mathbf{K}^{T}\) biçiminde çarpılarak ilişki puanları elde edilir. Bu hesabın ayrıntısını sonraki yapay zekâ makalelerinde inceleyeceğiz.
GPU'lar Matris Hesaplarında Neden Hızlıdır?
Büyük bir matris çarpımında çok sayıda benzer küçük hesap yapılır. Bunların önemli bir bölümü aynı anda yürütülebilir. Grafik işlemciler, yani GPU'lar, matris hesaplarını çok sayıda işlem birimine paylaştırabildiği için sinir ağlarının eğitimini hızlandırır. Yapılan matematiksel işlem aynı kalır.
Sık Yapılan Hatalar
- Boyutu ters okumak: \(3\times4\), üç sütun ve dört satır değil; üç satır ve dört sütun demektir.
- Her matrisi toplayabileceğini düşünmek: Toplama için matrislerin aynı boyutta olması gerekir.
- Matris çarpımını eleman eleman çarpımla karıştırmak: Matris çarpımında satır ile sütun eşleştirilir.
- Çarpım sırasını değiştirmek: Genel olarak \(\mathbf{A}\mathbf{B}\) ile \(\mathbf{B}\mathbf{A}\) aynı değildir; hatta bunlardan biri tanımlıyken diğeri tanımsız olabilir.
- Her kare matrisin tersi olduğunu sanmak: Determinant sıfırsa standart ters matris yoktur.
- Determinantı her matris için aramak: Determinant yalnızca kare matrisler için tanımlanır.
- Matrisi anlamından koparmak: Aynı sayı tablosu bir yerde müşteri verisini, başka bir yerde dönüşüm kuralını gösterebilir. Satırların ve sütunların neyi temsil ettiğini her zaman belirtmeliyiz.
Sonuç: Verileri Düzenlemek ve Dönüştürmek
Çay ve kahve sayılarını tuttuğumuz tabloyla başladık. Aynı satır ve sütun düzeninin hem verileri bir arada gösterebildiğini hem de bir vektörü dönüştüren kuralı taşıyabildiğini gördük.
Bir matrisin boyutu, dönüşümün kaç giriş beklediğini ve kaç çıkış ürettiğini de anlatır. Her satır giriş sayılarından bir ağırlıklı toplam kurar; matrisleri çarparak dönüşümleri birleştirebiliriz. Birim matris vektörü olduğu gibi bırakır. Ölçeklendirme ve döndürme matrisleri onu değiştirir; uygun koşullarda ters matris bu değişimi geri alır.
Determinant, alanın nasıl değiştiğini ve bir dönüşümde bilginin kaybolup kaybolmadığını gösterdi. Transpozla satırların ve sütunların yerini değiştirdik. Bir sinir ağı katmanındaki \(\mathbf{W}\mathbf{x}+\mathbf{b}\) hesabı da bu işlemlerin yapay zekâda nasıl kullanıldığını gösterdi.
Matrisle bir vektörü dönüştürebiliyoruz. Dönüşümden sonra ne kadar değiştiğini, iki veri noktasının birbirine ne kadar yakın olduğunu veya bir hata vektörünün büyüklüğünü ölçmek içinse başka araçlara ihtiyacımız var. Bir sonraki Normlar ve Mesafeler makalesinde bu ölçüleri inceleyeceğiz.
Yazar: Levent KARAGÖL